Insikter från Hivers AI-chef
De flesta antar att det bara handlar om planering, genomförande och lansering att bygga AI-funktioner för en kundserviceplattform.
Men om du pratar med personerna bakom kulisserna skulle du veta hur annorlunda verkligheten faktiskt är.
Anurag Maherchandani, AI-chef på Hiver, är en av dessa personer. På Hiver, en AI-driven kundserviceplattform som används av över 10 000 supportteam för att hantera kundkonversationer i stor skala, kom pressen att "lägga till AI" tidigt och med full kraft. Varje inkorg, varje ärende och varje kundinteraktion verkade vara en naturlig kandidat för automatisering.
Anurag leder alla Hivers AI-initiativ, vilket innebär att han ansvarar för att avgöra vad som ska byggas, hur det ska byggas och varför det bör vara viktigt för kunderna. Här är hans syn på vad som faktiskt krävs för att bygga AI-funktioner som fungerar.
Börja med resultatet, inte modellen
Kärnprincipen bakom varje AI-beslut hos Hiver: AI är inte produkten. Resultatet är produkten.
I praktiken innebär det att utgångspunkten för en AI-funktion aldrig är "vad kan den här modellen göra?" utan "var lägger människor tid på beslut som de inte borde behöva fatta?"
Den skillnaden formar allt som följer, från valet av problem till hur funktionen visas i användargränssnittet.
"När team säger att de 'bygger en AI-produkt' menar de vanligtvis att de har integrerat en modell, gjort den tillgänglig via ett användargränssnitt och uppnått hög noggrannhet. Men inget av detta garanterar värde. Användare köper inte intelligens. De köper lättnad: från repetitivt arbete, från osäkerhet och från operativ friktion," säger Anurag.
Även om en modell ser bra ut i tester är det verkliga lackmustestet huruvida den påverkar hur användarna arbetar.
Inferens eller regler: välj rätt verktyg först
Innan ett problem når stadiet där modellval eller datautvärdering blir aktuellt finns en mer grundläggande fråga: Kräver detta faktiskt inferens?
Inferens innebär att systemet behöver generalisera utifrån mönster som det inte uttryckligen har sett och göra bedömningar som inte helt kan beskrivas i förväg.
Regler innebär att logiken kan skrivas explicit: om X, så Y. De två är inte utbytbara, och att välja inferens när regler skulle räcka medför kostnader, fördröjning och oförutsägbarhet utan någon fördel.
När teamet på Hiver behövde konfigurera dirigering av e-post från specifika kundsegment, som VIP-konton, vissa branscher eller specifika domäner, var den första impulsen att bygga en AI-modell som kunde identifiera dem automatiskt.
I stället byggde Hiver konfigurerbara regelobjekt. Dessa använder explicit logik baserad på domäner, nyckelord och metadata. Resultatet är förutsägbart, enkelt att felsöka och konfigurerbart för slutanvändare utan att Hivers AI-team behöver involveras.
Om ett företag till exempel vill att all e-post från @enterprise.com eller meddelanden som innehåller ordet “avtal” ska gå till en prioriterad inkorg kan de konfigurera en regel på några minuter. Detta kräver ingen AI, och det finns ingen oklarhet kring hur e-postmeddelanden hanteras.
Som Anurag uttrycker det: "Om du kan skriva reglerna, skriv reglerna. Spara AI till problem där reglerna skulle vara omöjliga att räkna upp, där du behöver att systemet generaliserar utifrån mönster som det inte uttryckligen har sett."
Utvärdera problem som faktiskt kräver inferens
När ett problem verkligen kräver inferens utvärderar Hiver det utifrån fyra kriterier innan de beslutar att bygga:
- Frekvens. AI medför verkliga omkostnader: inferenskostnader, ökad fördröjning och oförutsägbara felmoder. Dessa omkostnader är bara motiverade när uppgiften förekommer tillräckligt ofta för att automatiseringen ska ge kumulativa fördelar. En uppgift som utförs några gånger i veckan motiverar sällan komplexiteten. En uppgift som agenter utför hundratals gånger om dagen gör det.
- Förutsägbarhet. Vissa klassificeringar beror på information som finns i indata (e-postinnehåll, ämnesrad, metadata) snarare än på inlärning från tillgängliga data. Andra beror på sammanhang som modellen helt enkelt inte har tillgång till: kundnivå, interna eskaleringspolicyer och agenters bedömningar som byggts upp över tid. Innan teamet beslutar sig för att bygga kör det genomförbarhetskontroller på historiska data för att avgöra om en förutsägelse över huvud taget är möjlig med en användbar konfidensnivå. Om signalen inte finns där förändrar inget arkitekturbeslut det.
- Kundernas efterfrågan. Löser detta ett problem som kunderna har uttryckt, eller ett problem som teamet har antagit att de har? Det förstnämnda har mycket högre sannolikhet att tas i bruk. Det sistnämnda leder ofta till funktioner som fungerar bra men ignoreras när det gäller användning.
- Insatser och reversibilitet. Vad händer när modellen har fel? En felklassificerad tagg som en agent korrigerar med ett klick medför en helt annan riskprofil än ett felaktigt svar som skickas till en kund eller en missad eskalering. Förutsägelser med låg insatsnivå och som enkelt kan återställas är starka kandidater för automatisering. Beslut med hög insatsnivå behöver antingen mänsklig granskning eller betydligt högre konfidensgränser innan de utlöser någon åtgärd.
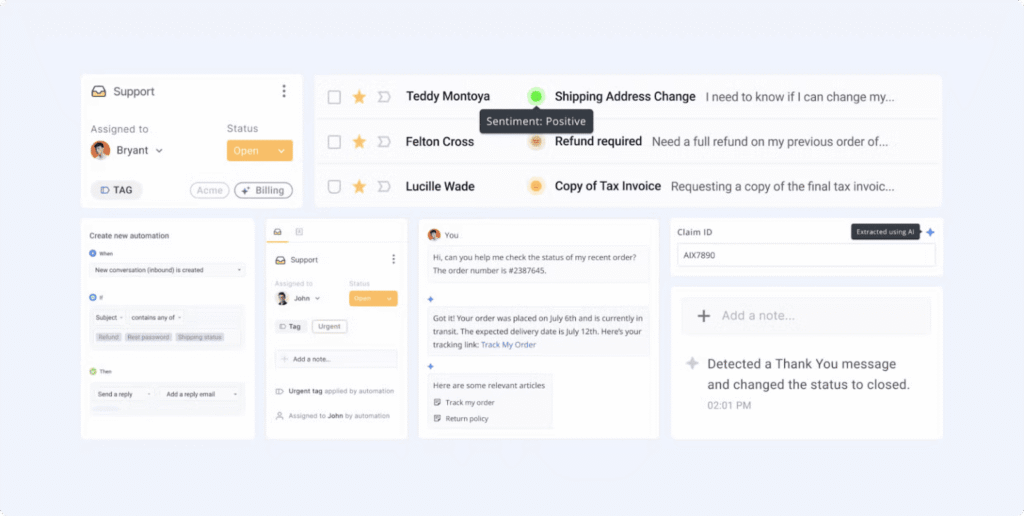
Hivers funktion för automatisk taggning fungerar eftersom den uppfyller alla fyra kriterier. Den använder en modell för att avgöra vilken tagg som är mest relevant för en inkommande konversation. Agenter behöver inte kategorisera varje ärende manuellt.
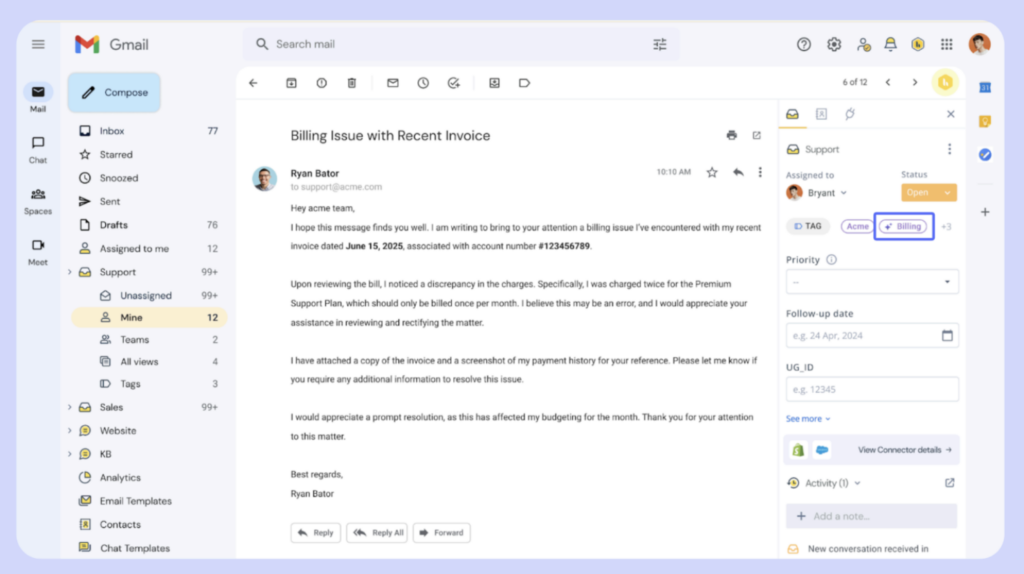
Teamet definierar en uppsättning taggar i administrationspanelen, till exempel ”Fakturering” eller ”Teknisk support.” Dessa fungerar som mål för förutsägelserna. Modellen lär sig mönster från e-postinnehållet, ämnesraden och metadata. Endast taggar med tydliga signaler inkluderas.
Agenter utför denna uppgift i nästan varje konversation, vilket gör den frekvent. Signalen finns i e-postinnehållet för de inkluderade taggarna, vilket gör den förutsägbar. Hivers kunder har uttryckligen bett om att minska den manuella triageringen, vilket driver användningen. När modellen har fel kan taggen korrigeras med ett klick, vilket håller insatserna låga och gör ändringen reversibel.
Sentimentanalys följer samma mönster. Den analyserar tonen i varje konversation för att identifiera om en kund är frustrerad, neutral eller positiv. Teamet ser detta i varje konversation, så funktionen har hög frekvens. Tonen finns i texten, vilket gör den förutsägbar.
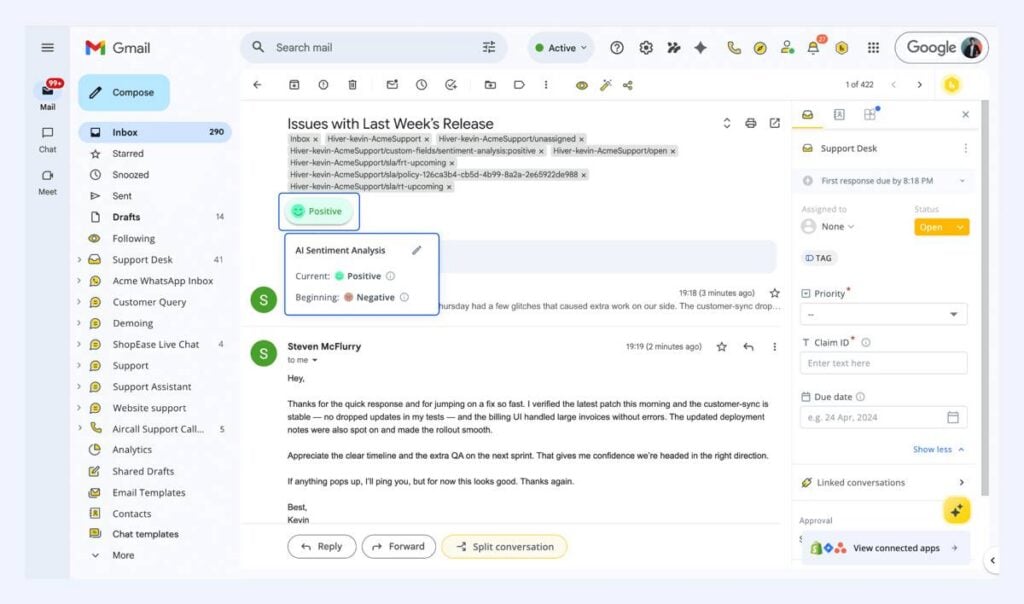
Teamet vill tidigt få insyn i frustrerade kunder, vilket skapar en tydlig efterfrågan. Om modellen har fel kan agenter åsidosätta den utan att påverka resultatet, vilket håller risken låg.
Genomförbarhetstestning före utveckling
En av de mer disciplinintensiva delarna av Hivers process är att köra genomförbarhetstester av träffsäkerheten innan någon produktionskod skrivs.
Funktionen för taggförslag är ett lärorikt exempel. Om ett e-postmeddelande till exempel säger ”Jag debiterades två gånger,” bör modellen välja ”Fakturering.” Men den försökte också välja taggar som ”VIP-kund” eller ”Eskalera till chef,” vilket inte kan utläsas ur själva e-postmeddelandet. Precisionen var låg, och agenterna slutade lita på resultatet.
Det underliggande problemet var att man inte skiljde mellan förutsägbara och oförutsägbara taggtyper. Kategoritaggar som ”Fakturering,” ”Teknisk support,” och ”Returer” motsvarar språkliga mönster i e-postinnehållet. De går att lära sig.
Operationella taggar som ”VIP-kund,” ”Väntar på juridik,” och ”Eskalera till chef” beror på sammanhang utanför indata: kontohistorik, interna affärsregler och samordning mellan team. Ingen modell som tränats på kunders e-postmeddelanden kommer att kunna förutsäga dem på ett tillförlitligt sätt.
Lösningen var strukturell: innan någon taggtyp inkluderas som mål för en förutsägelse genomgår den en genomförbarhetskontroll. Stöder historiska data en tillförlitlig förutsägelse av detta utfall? Om inte, utesluts den från modellens omfattning, oavsett hur användbar automatiseringen av taggen teoretiskt skulle kunna vara.
”Disciplinen i att säga ’den här taggtypen är inte en bra kandidat för automatisering’ var svårare än att bygga modellen. Men det innebar att vi bara lanserade förutsägelser som agenter kunde lita på.”
Att integrera AI i arbetsflödet, inte ovanpå det
Var AI finns i produkten är lika viktigt som vad den gör.
En funktion som får användare att stanna upp, skriva en instruktion och kontrollera resultatet innan de agerar har lagt till ett steg i arbetsflödet, inte tagit bort ett. Det är negativt netto även när AI:n är träffsäker. Användare som arbetar snabbt och hanterar ärende efter ärende kommer att kringgå allt som stör den rytmen.
Den designinriktning som fungerar är AI som agerar innan användaren behöver tänka på det. Med Hiver:
- E-postmeddelanden taggas innan handläggarna öppnar dem.
- Sentimentet beräknas och flaggas innan en handläggare öppnar konversationen: en frustrerad kund har redan hamnat högst upp i kön.
- Köordningen återspeglar prioritetssignaler utan att handläggarna behöver konfigurera något.
- Utkast till svar visas direkt i gränssnittet som förslag.
- Ärenden där modellens säkerhet understiger ett tröskelvärde skickas vidare för mänsklig granskning i stället för att någon åtgärd vidtas automatiskt.
Gränssnittet är inte utformat kring att be AI om hjälp. Handläggarna behöver inte aktivera den. E-postmeddelanden taggas och prioriteras innan de öppnar dem. AI minskar arbetsinsatsen innan handläggaren ens behöver tänka på det.
Det interna måttet på om detta fungerar: "Om användarna lägger märke till AI:n, har du förmodligen byggt den på fel sätt."
När det fungerar slutar användarna att nämna AI-funktionen. De nämner snabbare lösningstider, en mindre ärendebalans och enklare introduktion för nya handläggare. AI har gått från att vara synlig till att bli en strukturell del.
| 📌 Kundexempel: Så här fungerar det i praktiken |
|---|
| 📌 Kundexempel: Så här fungerar det i praktikenPå ITS Logistics hanterade teamen kundkonversationer i utspridda inkorgar, dirigerade förfrågningar manuellt och råkade ofta arbeta parallellt med varandra genom dubbla svar eller missade uppföljningar. Efter övergången till Hiver förändrades detta snabbt. Inom bara tre veckor minskade tiden för att återkomma med offerter med 61 %, och de flesta inkommande förfrågningarna dirigerades automatiskt till rätt person. Ännu viktigare var att varje konversation hade en tydlig ägare och att cheferna äntligen fick insyn i hur arbetet fortskred. Resultatet blev ett system som kunde hantera en växande efterfrågan utan att lägga till komplexitet eller personal, eftersom själva arbetet blev mer strukturerat och förutsägbart. “Hiver förvandlade utspridda frågor till ett strukturerat kundservicesystem. Varje förfrågan spåras, har en ägare och löses snabbare.” — Alejandro Arboleda, verksamhetschef, ITS Logistics. |
Noggrannhet och förtroende är olika problem
Ett system kan uppnå 95 % noggrannhet och ändå misslyckas i produktion om användarna inte har en tillförlitlig mental modell av när det kommer att ha fel.
Förtroende kommer från förutsägbarhet och kontroll. Användarna behöver förstå systemets beteende tillräckligt väl för att veta när de kan lita på det och när de ska åsidosätta det. Om de inte kan utveckla en sådan modell slutar de antingen att använda funktionen eller att kontrollera dess resultat, och båda är tecken på att systemet misslyckats.
Hivers metod är att göra korrigering till en central del av designen i stället för en reservlösning vid fel. Handläggarna kan åsidosätta alla förutsägelser med ett enda klick. Systemet samlar in ändringar som återkopplingssignaler. Tröskelvärden baserade på säkerhet avgör vad som tillämpas automatiskt och vad som visas för granskning.
Med Anurags ord: "I stället för att se åsidosättanden som misslyckanden byggde vi in dem som funktioner. Det gör att handläggarna behåller kontrollen och skapar en inlärningsloop utan att vi någonsin tränar på kunddata. Systemet blir bättre genom att observera resultaten."
Detta löser också ett dataproblem. Eftersom korrigeringar återförs som återkopplingssignaler förbättras modellen genom observerade resultat, utan att den behöver tillgång till rå kunddata.
Integritetsgränsen förblir intakt samtidigt som systemet blir mer träffsäkert över tid.
Två frågor innan någon AI-funktion lanseras
Innan en ny AI-funktion godkänns bör man ställa två frågor:
"Om den här funktionen togs bort i morgon, skulle användarna klaga?"
Om svaret är nej är funktionen ett tillägg, men inte nödvändig. Den har ännu inte förändrat hur människor arbetar. Det är den nivå man bör sträva efter.
"Minskar den här funktionen ett beslut eller skapar den ett nytt?"
Om användarna måste avgöra om de ska lita på AI:n, konfigurera den eller tolka dess resultat innan de kan agera, har AI lagt till kognitiv belastning i stället för att minska den.
Det är ett misslyckande oavsett teknisk prestanda.
Det verkliga arbetet bakom AI-funktioner
Att bygga AI som fungerar i produktion handlar mindre om modellval och mer om att välja rätt problem, testa genomförbarheten och utforma lösningen efter hur människor faktiskt arbetar. AI:n i sig är den minsta delen av problemet.
"Produkten var aldrig klassificering, sentimentanalys, utkast eller sammanfattningar. Produkten var färre beslut per handläggare, snabbare resultat, minskad kognitiv belastning och skalbar verksamhet. AI var mekanismen, och en mekanism fungerar bara när den tillämpas på rätt problem, med data som faktiskt stöder lösningen."
Om du funderar på var AI passar in i din supportverksamhet kan du prata med oss på Hiver. Vi visar hur vi kan hjälpa dig att ge empatisk support.