Indsigter fra Hivers chef for AI
De fleste antager, at udvikling af AI-funktioner til en kundeserviceplatform blot handler om planlægning, udførelse og lancering.
Men hvis du taler med personerne bag kulisserne, vil du vide, hvor anderledes virkeligheden virkelig er.
Anurag Maherchandani, chef for AI hos Hiver, er en af disse personer. Hos Hiver, en AI-drevet kundeserviceplatform, der bruges af over 10.000 supportteams til at håndtere kundesamtaler i stor skala, kom presset for at "tilføje AI" tidligt og hårdt. Hver indbakke, hver sag og enhver kundeinteraktion virkede som en naturlig kandidat til automatisering.
Anurag leder alle Hivers AI-initiativer, hvilket betyder, at han er ansvarlig for at finde ud af, hvad der skal bygges, hvordan det skal bygges, og hvorfor det bør være vigtigt for kunderne. Her er hans syn på, hvad der egentlig kræves for at udvikle AI-funktioner, der fungerer.
Start med resultatet, ikke modellen
Det grundlæggende princip bag alle AI-beslutninger hos Hiver: AI er ikke produktet. Resultatet er produktet.
I praksis betyder det, at udgangspunktet for enhver AI-funktion aldrig er "hvad kan denne model gøre?" Det er "hvor bruger mennesker tid på beslutninger, de ikke burde skulle træffe?"
Denne skelnen former alt, hvad der følger, fra valg af problem til hvordan funktionen præsenteres i brugergrænsefladen.
"Når teams siger, at de 'bygger et AI-produkt', mener de som regel, at de har integreret en model, gjort den tilgængelig gennem en brugergrænseflade og opnået høj nøjagtighed. Men intet af dette garanterer værdi. Brugere køber ikke intelligens. De køber lettelse: fra gentagende arbejde, fra usikkerhed, fra operationelle hindringer," siger Anurag.
Selv hvis en model ser fremragende ud i test, er den egentlige lakmustest, om den påvirker den måde, brugerne arbejder på.
Want to learn more about Hiver?
Slutning eller regler: Vælg først det rigtige værktøj
Før et problem når til stadiet med modelvalg eller dataevaluering, er der et mere grundlæggende spørgsmål: Kræver dette faktisk slutning?
Slutning betyder, at systemet skal generalisere ud fra mønstre, det ikke eksplicit har set, og træffe vurderinger, der ikke fuldt ud kan fastlægges på forhånd.
Regler betyder, at logikken kan skrives eksplicit: hvis X, så Y. De to ting kan ikke erstatte hinanden, og hvis man griber til slutning, når regler ville være tilstrækkelige, medfører det omkostninger, latenstid og uforudsigelighed uden nogen gevinst.
Da teamet hos Hiver havde brug for at opsætte dirigering af e-mails fra specifikke kundesegmenter som VIP-konti, bestemte brancher eller specifikke domæner, var den første indskydelse at bygge en AI-model, der automatisk kunne identificere dem.
I stedet byggede Hiver konfigurerbare regelobjekter. Disse bruger eksplicit logik baseret på domæner, nøgleord og metadata. Resultatet er forudsigeligt, nemt at fejlfinde og kan konfigureres af slutbrugere uden at involvere Hivers AI-team.
Hvis en virksomhed for eksempel ønsker, at alle e-mails fra @enterprise.com eller meddelelser, der indeholder ordet “kontrakt”, skal gå til en prioriteret indbakke, kan den opsætte en regel på få minutter. Dette kræver ingen AI, og der er ingen tvetydighed i, hvordan e-mails håndteres.
Som Anurag siger: "Hvis du kan skrive reglerne, så skriv reglerne. Gem AI til problemer, hvor reglerne ville være umulige at opregne, og hvor du har brug for, at systemet generaliserer ud fra mønstre, det ikke eksplicit har set."
Evaluering af problemer, der faktisk kræver slutning
Når et problem reelt kræver slutning, evaluerer Hiver det ud fra fire kriterier, før de beslutter sig for at bygge:
- Hyppighed. AI har reelle omkostninger: inferensomkostninger, øget latenstid og uforudsigelige fejltilstande. Disse omkostninger giver kun mening, når opgaven forekommer ofte nok til, at automatisering kan skabe kumulative gevinster. En opgave, der udføres et par gange om ugen, retfærdiggør sjældent kompleksiteten. Det gør en opgave, som agenter udfører hundredvis af gange om dagen.
- Forudsigelighed. Nogle klassifikationer afhænger af oplysninger, der findes i inputtet (e-mailindhold, emnelinje, metadata), snarere end af læring fra tilgængelige data. Andre afhænger af kontekst, som modellen simpelthen ikke har: kundesegment, interne eskaleringspolitikker eller agentens dømmekraft, der er opbygget over tid. Før teamet beslutter sig for at bygge, udfører det gennemførlighedstjek på historiske data for at afgøre, om en forudsigelse overhovedet er mulig med et nyttigt konfidensniveau. Hvis signalet ikke er der, ændrer ingen arkitekturbeslutning på det.
- Kundetræk. Løser dette et problem, som kunderne har givet udtryk for, eller et problem, som teamet har antaget, at de har? Førstnævnte har en langt højere sandsynlighed for at blive taget i brug. Sidstnævnte resulterer ofte i funktioner, der fungerer godt, men bliver ignoreret, når det kommer til anvendelse.
- Konsekvenser og reversibilitet. Hvad sker der, når modellen tager fejl? Et forkert klassificeret tag, som en agent retter med ét klik, indebærer en helt anden risikoprofil end et fejlsendt svar til en kunde eller en overset eskalering. Forudsigelser med lave konsekvenser, som nemt kan omgøres, er stærke kandidater til automatisering. Beslutninger med høje konsekvenser kræver enten menneskelig gennemgang eller betydeligt højere konfidensgrænser, før de udløses.
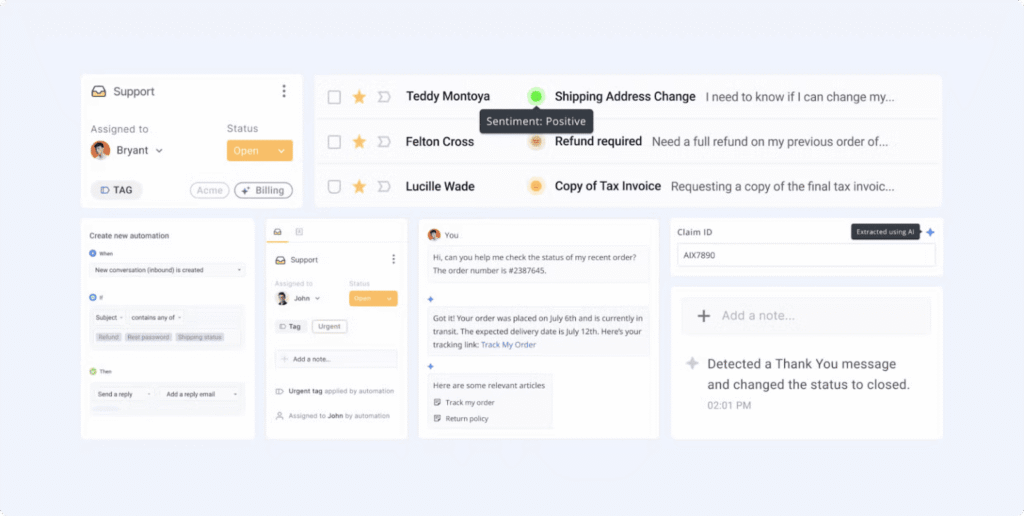
Hivers funktion til automatisk tagging fungerer, fordi den opfylder alle fire kriterier. Den bruger en model til at udlede det mest relevante tag for en indgående samtale. Agenter behøver ikke manuelt at kategorisere hver ticket.
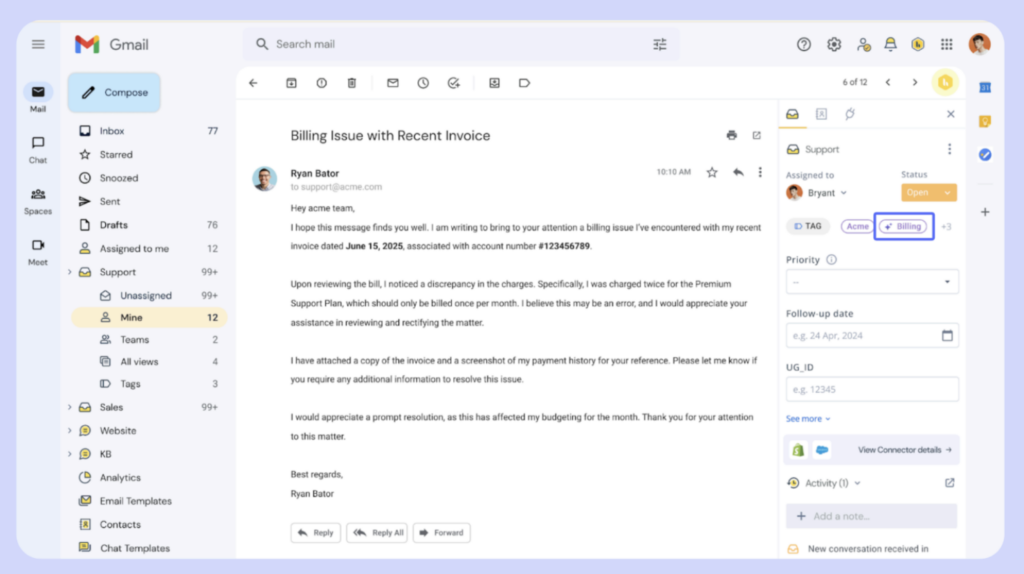
Teams definerer et sæt tags i administrationspanelet, såsom “Fakturering” eller “Teknisk support.” Disse fungerer som forudsigelsesmålene. Modellen lærer mønstre fra e-mailindholdet, emnelinjen og metadataene. Kun tags med tydelige signaler inkluderes.
Agenter udfører denne opgave på næsten hver samtale, hvilket gør den hyppig. Signalet findes i e-mailindholdet for de inkluderede tags, hvilket gør den forudsigelig. Hivers kunder har udtrykkeligt bedt om at reducere manuel sortering, hvilket fremmer anvendelsen. Når modellen tager fejl, kan tagget rettes med ét klik, hvilket holder konsekvenserne lave og gør fejlen nem at omgøre.
Sentimentanalyse følger samme mønster. Den analyserer tonen i hver samtale for at identificere, om en kunde er frustreret, neutral eller positiv. Teams ser dette på tværs af hver samtale, så det forekommer hyppigt. Tonen findes i teksten, hvilket gør den forudsigelig.
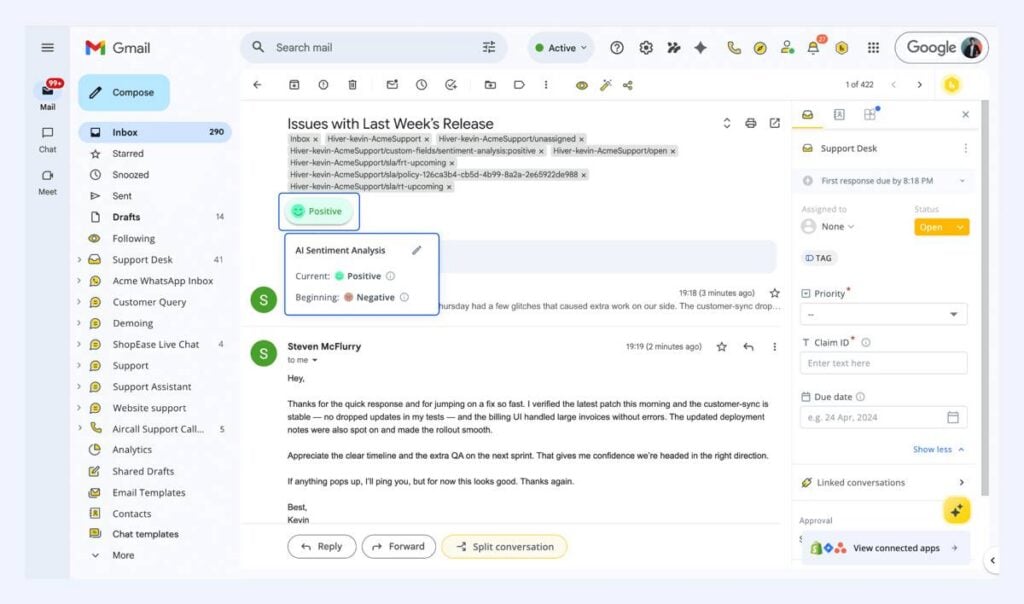
Teams ønsker tidlig indsigt i frustrerede kunder, hvilket skaber en tydelig efterspørgsel. Hvis modellen tager fejl, kan agenter tilsidesætte den uden at påvirke resultatet, hvilket holder risikoen lav.
Gennemførlighedstest før udvikling
En af de mere disciplinintensive dele af Hivers proces: at køre gennemførlighedstest af nøjagtigheden, før der skrives produktionskode.
Funktionen til tagforslag er et lærerigt eksempel. Hvis en e-mail for eksempel siger, “Jeg er blevet opkrævet to gange,” bør modellen vælge “Fakturering.” Men den forsøgte også at vælge tags som “VIP-kunde” eller “Eskaler til leder,” som ikke kan udledes af selve e-mailen. Præcisionen var dårlig, og agenterne holdt op med at stole på resultatet.
Det underliggende problem var, at man ikke skelnede mellem forudsigelige og uforudsigelige tagtyper. Kategoritags som "Fakturering," "Teknisk support," og "Returneringer" svarer til sproglige mønstre i e-mailindholdet. De kan læres.
Operationelle tags som "VIP-kunde," "Afventer juridisk afdeling," og "Eskaler til leder" afhænger af kontekst uden for inputtet: kontohistorik, interne forretningsregler og koordinering mellem teams. Ingen model, der er trænet på kunde-e-mails, vil kunne forudsige dem pålideligt.
Løsningen var strukturel: Før en tagtype inkluderes som et forudsigelsesmål, gennemgår den et gennemførlighedstjek. Understøtter historiske data en pålidelig forudsigelse af dette udfald? Hvis ikke, udelukkes det fra modellens anvendelsesområde, uanset hvor nyttig automatisering af dette tag teoretisk set ville være.
"Disciplinen med at sige 'denne tagtype er ikke en god kandidat til automatisering' var sværere end at bygge modellen. Men det betød, at vi kun lancerede forudsigelser, som agenterne kunne stole på."
Integrering af AI i arbejdsgangen, ikke oven på den
Hvor AI er placeret i produktet, betyder lige så meget som, hvad den gør.
En funktion, der får brugerne til at stoppe op, skrive en prompt og kontrollere resultatet, før de handler, har tilføjet et trin til arbejdsgangen i stedet for at fjerne et. Det er samlet set negativt, selv når AI'en er præcis. Brugere, der arbejder hurtigt og håndterer ticket efter ticket, vil omgå alt, der afbryder denne rytme.
Den designretning, der fungerer: AI, der handler, før brugeren behøver at tænke over det. Med Hiver:
- E-mails mærkes, før agenterne åbner dem.
- Sentiment beregnes og markeres, før en agent åbner samtalen: En frustreret kunde er allerede placeret øverst i køen.
- Køens rækkefølge afspejler prioritetssignaler, uden at agenterne skal konfigurere noget.
- Udkast til svar vises direkte som forslag.
- Sager, hvor modellens sikkerhed falder under en tærskel, vises til menneskelig gennemgang i stedet for at udløse en automatisk handling.
Grænsefladen er ikke bygget op omkring at bede AI om hjælp. Agenterne behøver ikke at aktivere den. E-mails mærkes og prioriteres, før de åbner dem. AI fjerner arbejdsbyrden, før agenten behøver at tænke over det.
Den interne måling af, om dette fungerer: "Hvis brugerne lægger mærke til AI, har du sandsynligvis bygget det forkert."
Når det fungerer, holder brugerne op med at nævne AI-funktionen. De nævner hurtigere løsningstider, en mindre sagspukkel og lettere oplæring af nye agenter. AI er gået fra at være synlig til at være strukturel.
| 📌 Kundecase: Sådan fungerer det i praksis |
|---|
| 📌 Kundecase: Sådan fungerer det i praksisHos ITS Logistics håndterede teams kundesamtaler på tværs af spredte indbakker, dirigerede anmodninger manuelt og kom ofte hinanden i vejen med dublerede svar eller manglende opfølgninger. Efter overgangen til Hiver ændrede det sig hurtigt. Allerede inden for tre uger faldt behandlingstiden for tilbud med 61 %, og de fleste indkommende anmodninger blev automatisk sendt til den rette person. Endnu vigtigere var det, at hver samtale havde et tydeligt ejerskab, og at lederne endelig fik indblik i, hvordan arbejdet skred frem. Resultatet blev et system, der kunne håndtere stigende efterspørgsel uden at tilføre kompleksitet eller flere medarbejdere, fordi selve arbejdet blev mere struktureret og forudsigeligt. “Hiver forvandlede spredte forespørgsler til et struktureret kundeservicesystem. Hver anmodning spores, har en ansvarlig og løses hurtigere.” — Alejandro Arboleda, driftsdirektør, ITS Logistics. |
Nøjagtighed og tillid er forskellige problemer
Et system kan opnå 95 % nøjagtighed og stadig fejle i produktion, hvis brugerne ikke har en pålidelig mental model af, hvornår det vil tage fejl.
Tillid kommer fra forudsigelighed og kontrol. Brugerne skal forstå systemets adfærd godt nok til at vide, hvornår de kan stole på det, og hvornår de skal tilsidesætte det. Hvis de ikke kan opbygge denne model, vil de enten holde op med at bruge funktionen eller holde op med at kontrollere dens output, og begge dele er fejltilstande.
Hivers tilgang er at gøre korrektion til en central del af designet i stedet for en nødløsning ved fejl. Agenter kan tilsidesætte enhver forudsigelse med et enkelt klik. Systemet registrerer ændringer som feedbacksignaler. Tærskler baseret på sikkerhed afgør, hvad der anvendes automatisk, og hvad der vises til gennemgang.
Med Anurags ord: "I stedet for at betragte tilsidesættelser som fejl byggede vi dem ind som funktioner. Det holder agenterne i kontrol og skaber en læringssløjfe, uden at vi nogensinde træner på kundedata. Systemet bliver bedre ved at observere resultater."
Det løser også et dataproblem. Fordi korrektioner sendes tilbage som feedbacksignaler, forbedres modellen gennem observerede resultater i stedet for at kræve adgang til rå kundedata.
Privatlivsgrænsen forbliver intakt, samtidig med at systemet bliver mere nøjagtigt over tid.
To spørgsmål, før en AI-funktion lanceres
Før en ny AI-funktion godkendes, skal man stille to spørgsmål:
"Hvis denne funktion blev fjernet i morgen, ville brugerne så klage?"
Hvis svaret er nej, er funktionen et supplement, men ikke essentiel. Den har endnu ikke ændret den måde, folk arbejder på. Det er den standard, det er værd at stræbe efter.
"Reducerer denne funktion en beslutning, eller skaber den en ny?"
Hvis brugerne skal beslutte, om de vil stole på AI, konfigurere den eller fortolke dens output, før de kan handle, har AI tilføjet kognitiv belastning i stedet for at fjerne den.
Det er en fejl uanset den tekniske ydeevne.
Det egentlige arbejde bag AI-funktioner
At bygge AI, der fungerer i produktionen, handler mindre om valg af model og mere om valg af problem, afprøvning af gennemførlighed og design til den måde, folk faktisk arbejder på. Selve AI'en er den mindste del af problemet.
"Produktet var aldrig klassifikation, sentimentanalyse, udarbejdelse af udkast eller opsummering. Produktet var færre beslutninger pr. agent, hurtigere resultater, mindre kognitiv belastning og skalerbare processer. AI var mekanismen, og en mekanisme fungerer kun, når den anvendes på det rigtige problem med data, der faktisk understøtter løsningen."
Hvis du overvejer, hvor AI passer ind i din supportdrift, talk to us hos Hiver. Vi viser dig, hvordan vi kan hjælpe dig med at levere empatisk support.