Innsikt fra Hivers AI-sjef
De fleste antar at det å bygge AI-funksjoner for en kundeserviceplattform bare handler om planlegging, gjennomføring og lansering.
Men hvis du snakker med menneskene bak kulissene, vil du vite hvor annerledes virkeligheten faktisk er.
Anurag Maherchandani, AI-sjef i Hiver, er en av disse personene. Hos Hiver, en AI-drevet kundeserviceplattform som brukes av over 10 000 supportteam til å håndtere kundesamtaler i stor skala, kom presset om å «legge til AI» tidlig og med full styrke. Hver innboks, hver sak og hver kundeinteraksjon føltes som en naturlig kandidat for automatisering.
Anurag leder alle Hivers AI-initiativer, noe som betyr at han har ansvar for å finne ut hva som skal bygges, hvordan det skal bygges, og hvorfor det bør være viktig for kundene. Her er hans syn på hva som faktisk kreves for å bygge AI-funksjoner som fungerer.
Start med resultatet, ikke modellen
Kjerneprinsippet bak alle AI-beslutninger hos Hiver: AI er ikke produktet. Resultatet er produktet.
I praksis betyr dette at utgangspunktet for enhver AI-funksjon aldri er «hva kan denne modellen gjøre?» Det er «hvor bruker mennesker tid på beslutninger de ikke burde måtte ta?»
Dette skillet former alt som følger, fra valg av problem til hvordan funksjonen presenteres i brukergrensesnittet.
«Når team sier at de «bygger et AI-produkt», mener de vanligvis at de har integrert en modell, gjort den tilgjengelig gjennom et brukergrensesnitt og oppnådd høy nøyaktighet. Men ingenting av dette garanterer verdi. Brukere kjøper ikke intelligens. De kjøper avlastning: fra repetitive oppgaver, fra usikkerhet og fra operasjonell friksjon», sier Anurag.
Selv om en modell ser imponerende ut i testing, er den virkelige lakmustesten hvorvidt den påvirker måten brukerne arbeider på.
Want to learn more about Hiver?
Slutning eller regler: Velg riktig verktøy først
Før et problem når stadiet for modellvalg eller dataevaluering, finnes det et mer grunnleggende spørsmål: Krever dette faktisk slutning?
Slutning betyr at systemet må generalisere ut fra mønstre det ikke eksplisitt har sett, og ta avgjørelser som ikke kan beskrives fullstendig på forhånd.
Regler betyr at logikken kan skrives eksplisitt: hvis X, så Y. De to er ikke utskiftbare, og det å ty til slutning når regler ville vært tilstrekkelig, tilfører kostnad, forsinkelse og uforutsigbarhet uten noen gevinst.
Da teamet hos Hiver trengte å sette opp ruting for e-poster fra bestemte kundesegmenter, som VIP-kontoer, bestemte bransjer eller spesifikke domener, var den første innskytelsen å bygge en AI-modell som kunne identifisere dem automatisk.
I stedet bygget Hiver konfigurerbare regelobjekter. Disse bruker eksplisitt logikk basert på domener, nøkkelord og metadata. Resultatet er forutsigbart, enkelt å feilsøke og konfigurerbart for sluttbrukere uten å involvere Hivers AI-team.
Hvis en bedrift for eksempel ønsker at alle e-poster fra @enterprise.com eller meldinger som inneholder ordet «kontrakt», skal gå til en prioritert innboks, kan de sette opp en regel på få minutter. Dette krever ingen AI, og det er ingen tvil om hvordan e-postene håndteres.
Som Anurag sier: «Hvis du kan skrive reglene, så skriv reglene. Spar AI til problemer der det ville være umulig å liste opp alle reglene, og der du trenger at systemet generaliserer ut fra mønstre det ikke eksplisitt har sett.»
Evaluere problemer som faktisk krever slutning
Når et problem faktisk krever slutning, vurderer Hiver det opp mot fire kriterier før de beslutter å bygge:
- Hyppighet. AI har reelle kostnader: inferenskostnader, økt forsinkelse og uforutsigbare feilmønstre. Disse kostnadene gir bare mening når oppgaven skjer ofte nok til at automatisering får en kumulativ effekt. En oppgave som skjer noen få ganger i uken, rettferdiggjør sjelden kompleksiteten. En oppgave agenter utfører hundrevis av ganger om dagen, gjør det.
- Forutsigbarhet. Noen klassifiseringer avhenger av informasjon som finnes i inndataene (e-postinnhold, emnelinje, metadata), i stedet for at modellen lærer fra tilgjengelige data. Andre avhenger av kontekst modellen ganske enkelt ikke har: kundesegment, interne eskaleringsregler eller agentens skjønn som er bygget opp over tid. Før teamet bestemmer seg for å bygge, gjennomfører det gjennomførbarhetstester på historiske data for å avgjøre om en prediksjon i det hele tatt er mulig med et nyttig konfidensnivå. Hvis signalet ikke finnes, vil ingen arkitekturbeslutning endre på det.
- Kundedrevet etterspørsel. Løser dette et problem kundene har uttrykt, eller et problem teamet har antatt at de har? Det førstnevnte har mye høyere sannsynlighet for å bli tatt i bruk. Det sistnevnte har en tendens til å føre til funksjoner som fungerer godt, men som blir ignorert når det gjelder adopsjon.
- Konsekvenser og reverserbarhet. Hva skjer når modellen tar feil? En feilklassifisert tagg som en agent korrigerer med ett klikk, innebærer en helt annen risikoprofil enn et feilaktig svar som sendes til en kunde, eller en eskalering som ikke blir fanget opp. Prediksjoner med lave konsekvenser som enkelt kan reverseres, er gode kandidater for automatisering. Beslutninger med store konsekvenser trenger enten menneskelig kontroll eller betydelig høyere konfidensgrenser før de utløses.
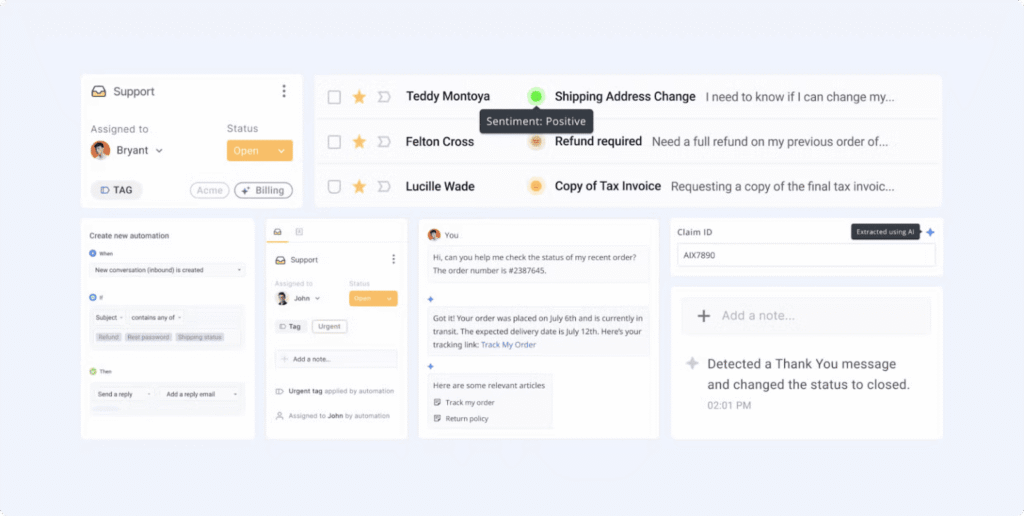
Hivers funksjon for automatisk tagging fungerer fordi den oppfyller alle fire kriteriene. Den bruker en modell til å utlede den mest relevante taggen for en innkommende samtale. Agenter trenger ikke å kategorisere hver sak manuelt.
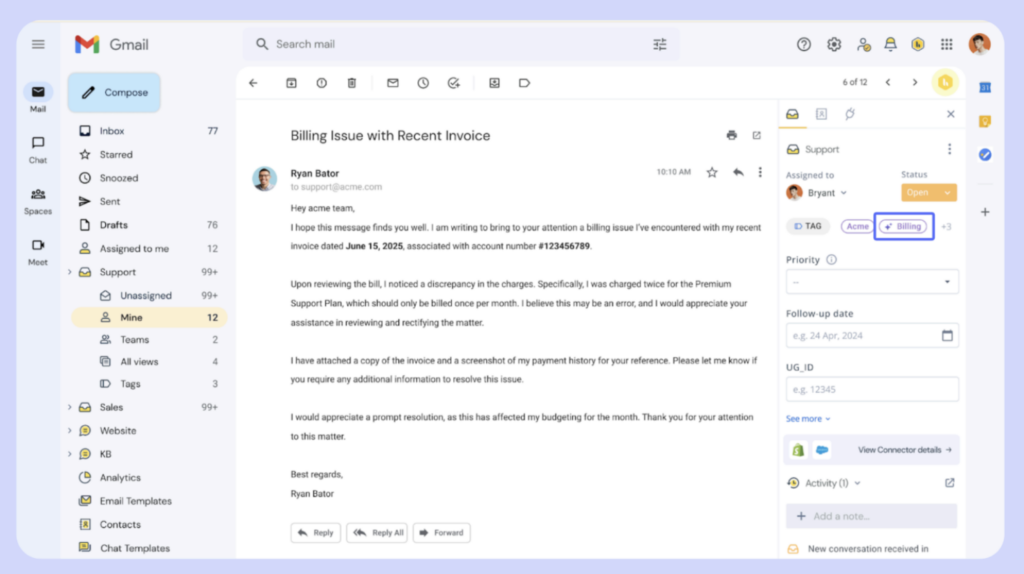
Team definerer et sett med tagger i administrasjonspanelet, for eksempel «Fakturering» eller «Teknisk støtte.» Disse fungerer som prediksjonsmålene. Modellen lærer mønstre fra e-postinnholdet, emnelinjen og metadataene. Bare tagger med tydelige signaler inkluderes.
Agenter utfører denne oppgaven i nesten alle samtaler, noe som gjør den hyppig. Signalet finnes i e-postinnholdet for de inkluderte taggene, noe som gjør den forutsigbar. Hivers kunder har uttrykkelig bedt om å redusere manuell sortering, noe som driver adopsjonen. Når modellen tar feil, kan taggen korrigeres med ett klikk, noe som holder konsekvensene små og gjør feilen enkel å reversere.
Sentimentanalyse følger samme mønster. Den analyserer tonen i hver samtale for å identifisere om en kunde er frustrert, nøytral eller positiv. Team ser dette på tvers av alle samtaler, så det skjer hyppig. Tonen finnes i teksten, noe som gjør den forutsigbar.
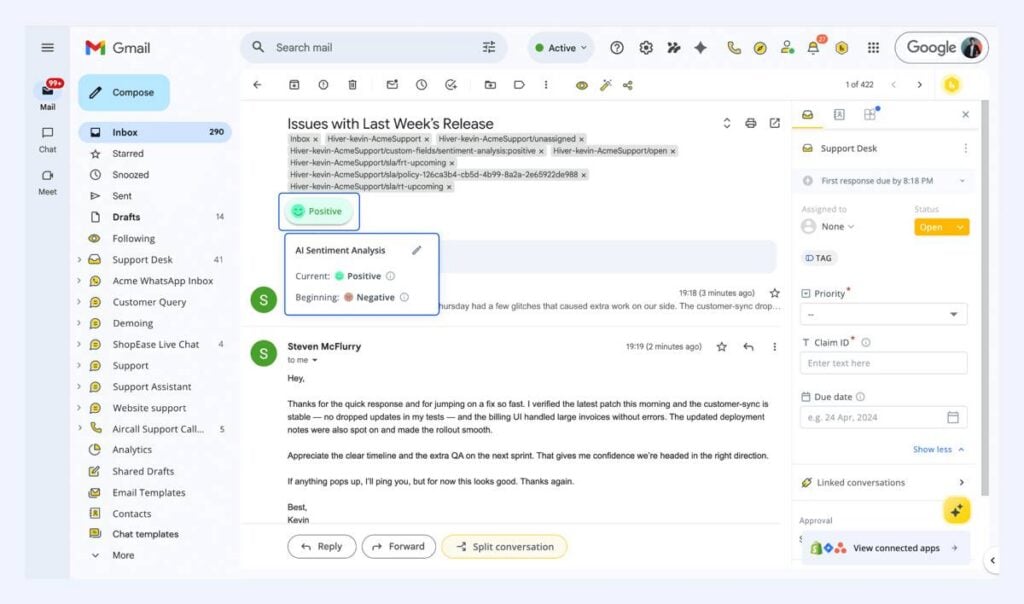
Team ønsker tidlig innsikt i frustrerte kunder, noe som skaper tydelig etterspørsel. Hvis modellen tar feil, kan agenter overstyre den uten at det påvirker utfallet, noe som holder risikoen lav.
Gjennomførbarhetstesting før bygging
En av de mer disiplinkrevende delene av Hivers prosess er å gjennomføre gjennomførbarhetstester for nøyaktighet før produksjonskode skrives.
Funksjonen for forslag til tagger er et lærerikt eksempel. Hvis en e-post for eksempel sier «Jeg ble belastet to ganger», bør modellen velge «Fakturering». Men den prøvde også å velge tagger som «VIP-kunde» eller «Eskaler til leder», som ikke kan utledes fra selve e-posten. Presisjonen var dårlig, og agentene sluttet å stole på resultatet.
Det underliggende problemet var at man ikke skilte mellom forutsigbare og uforutsigbare taggtyper. Kategoritagger som «Fakturering», «Teknisk støtte» og «Returer» samsvarer med språklige mønstre i e-postinnholdet. De kan læres.
Operasjonelle tagger som «VIP-kunde», «Venter på juridisk avklaring» og «Eskaler til leder» avhenger av kontekst utenfor inndataene: kontohistorikk, interne forretningsregler og koordinering mellom team. Ingen modell som er trent på kunde-e-poster, vil kunne forutsi dem pålitelig.
Løsningen var strukturell: Før en taggtype inkluderes som et prediksjonsmål, gjennomgår den en gjennomførbarhetssjekk. Støtter historiske data pålitelig prediksjon av dette utfallet? Hvis ikke, utelukkes den fra modellens virkeområde, uavhengig av hvor nyttig automatisering av taggen teoretisk sett ville vært.
«Disiplinen det krevde å si «denne taggtypen er ikke en god kandidat for automatisering», var vanskeligere enn å bygge modellen. Men det betydde at vi bare lanserte prediksjoner agenter kunne stole på.»
Å bygge AI inn i arbeidsflyten, ikke legge den oppå den
Hvor AI befinner seg i produktet, er like viktig som hva den gjør.
En funksjon som får brukerne til å stoppe opp, skrive inn en ledetekst og kontrollere resultatet før de utfører en handling, har lagt til et trinn i arbeidsflyten i stedet for å fjerne ett. Det er netto negativt selv når AI-en er nøyaktig. Brukere som jobber raskt og håndterer sak etter sak, vil finne en vei rundt alt som avbryter denne rytmen.
Designretningen som fungerer, er AI som handler før brukeren trenger å tenke på det. Med Hiver:
- E-poster merkes før agentene åpner dem.
- Sentiment beregnes og flagges før en agent åpner samtalen: En frustrert kunde har allerede dukket opp øverst i køen.
- Køsorteringen gjenspeiler prioritetssignaler uten at agentene trenger å konfigurere noe.
- Utkast til svar vises direkte som forslag.
- Saker der modellens sikkerhet faller under en terskel, vises for menneskelig gjennomgang i stedet for at noen handling utføres automatisk.
Grensesnittet er ikke bygget rundt å be kunstig intelligens om hjelp. Agentene trenger ikke å aktivere den. E-poster merkes og prioriteres før de åpner dem. Den kunstige intelligensen fjerner arbeidsmengde før agenten trenger å tenke over det.
Det interne målet på om dette fungerer: "Hvis brukerne legger merke til den kunstige intelligensen, har du sannsynligvis bygget den feil."
Når det fungerer, slutter brukerne å nevne funksjonen for kunstig intelligens. De nevner raskere løsningstider, mindre restanse og enklere opplæring av nye agenter. Den kunstige intelligensen har gått fra å være synlig til å bli strukturell.
| 📌 Kundeblikk: Slik fungerer dette i praksis |
|---|
| 📌 Kundeblikk: Slik fungerer dette i praksisHos ITS Logistics håndterte teamene kundesamtaler på tvers av spredte innbokser, sendte forespørsler manuelt videre og tråkket ofte hverandre på tærne med dupliserte svar eller manglende oppfølging. Etter overgangen til Hiver endret dette seg raskt. I løpet av bare tre uker ble behandlingstiden for tilbud redusert med 61 %, og de fleste innkommende forespørslene ble automatisk sendt til riktig person. Enda viktigere var det at hver samtale hadde et tydelig ansvar, og at lederne endelig fikk oversikt over hvordan arbeidet utviklet seg. Resultatet var et system som kunne håndtere økende etterspørsel uten å tilføre kompleksitet eller flere ansatte, fordi selve arbeidet ble mer strukturert og forutsigbart. “Hiver gjorde spredte forespørsler om til et strukturert kundeservicesystem. Hver forespørsel spores, har en ansvarlig og løses raskere.” — Alejandro Arboleda, driftsdirektør, ITS Logistics. |
Nøyaktighet og tillit er ulike problemer
Et system kan oppnå 95 % nøyaktighet og likevel mislykkes i produksjon hvis brukerne ikke har en pålitelig mental modell av når det vil ta feil.
Tillit kommer fra forutsigbarhet og kontroll. Brukerne må forstå systemets atferd godt nok til å vite når de kan stole på det, og når de bør overstyre det. Hvis de ikke kan utvikle en slik modell, vil de enten slutte å bruke funksjonen eller slutte å kontrollere resultatet, og begge deler er tegn på at den mislykkes.
Hivers tilnærming er å gjøre korrigering til en sentral del av utformingen, i stedet for en reserveløsning ved feil. Agentene kan overstyre enhver prediksjon med ett enkelt klikk. Systemet registrerer endringer som tilbakemeldingssignaler. Terskler basert på sikkerhet avgjør hva som brukes automatisk, og hva som vises for gjennomgang.
Med Anurags ord: "I stedet for å behandle overstyringer som feil bygget vi dem inn som funksjoner. Det holder agentene i kontroll og skaper en læringssløyfe uten at vi noen gang trener på kundedata. Systemet blir bedre ved å observere resultater."
Dette løser også et dataproblem. Fordi korrigeringer føres tilbake som tilbakemeldingssignaler, forbedres modellen gjennom observerte resultater i stedet for at den trenger tilgang til rå kundedata.
Personverngrensene opprettholdes samtidig som systemet blir mer nøyaktig over tid.
To spørsmål før en AI-funksjon lanseres
Før en ny AI-funksjon godkjennes, bør man stille to spørsmål:
"Hvis denne funksjonen ble fjernet i morgen, ville brukerne klage?"
Hvis svaret er nei, er funksjonen et tillegg, men ikke avgjørende. Den har ennå ikke endret måten folk arbeider på. Det er denne standarden det er verdt å bygge mot.
"Reduserer denne funksjonen en beslutning, eller skaper den en ny?"
Hvis brukerne må avgjøre om de skal stole på AI-en, konfigurere den eller tolke resultatet før de kan handle, har AI-en økt den kognitive belastningen i stedet for å redusere den.
Det er en fiasko uavhengig av den tekniske ytelsen.
Det virkelige arbeidet bak AI-funksjoner
Å bygge AI som fungerer i produksjon handler mindre om valg av modell og mer om valg av problem, testing av gjennomførbarhet og utforming for hvordan folk faktisk arbeider. Selve AI-en er den minste delen av problemet.
"Produktet var aldri klassifisering, sentimentanalyse, utarbeiding av utkast eller oppsummering. Produktet var færre beslutninger per agent, raskere resultater, redusert kognitiv belastning og skalerbar drift. AI var mekanismen, og en mekanisme fungerer bare når den brukes på riktig problem, med data som faktisk støtter løsningen."
Hvis du vurderer hvor AI passer inn i kundestøttearbeidet ditt, snakk med oss hos Hiver. Vi viser deg hvordan vi kan hjelpe deg med å levere empatisk kundestøtte.