Näkemyksiä Hiverin tekoälyjohtajalta
Useimmat olettavat, että tekoälyominaisuuksien rakentaminen asiakaspalvelualustalle on vain suunnittelua, toteutusta ja julkaisemista.
Mutta jos puhut kulissien takana työskenteleville ihmisille, ymmärrät, kuinka erilainen todellisuus todella on.
Anurag Maherchandani, Hiverin tekoälyjohtaja, on yksi näistä ihmisistä. Hiver on tekoälypohjainen asiakaspalvelualusta, jota yli 10 000 tukitiimiä käyttää asiakasviestinnän käsittelyyn suuressa mittakaavassa. Siellä paine "tekoälyn lisäämiseen" alkoi varhain ja oli kova. Jokainen postilaatikko, jokainen tukipyyntö ja jokainen asiakasvuorovaikutus vaikutti luonnolliselta automaation kohteelta.
Anurag johtaa kaikkia Hiverin tekoäly-hankkeita, mikä tarkoittaa, että hänen vastuullaan on selvittää, mitä rakennetaan, miten se rakennetaan ja miksi sen pitäisi olla asiakkaille merkityksellistä. Tässä on hänen näkemyksensä siitä, mitä todella tarvitaan toimivien tekoälyominaisuuksien rakentamiseen.
Aloita lopputuloksesta, älä mallista
Hiverin jokaisen tekoälyä koskevan päätöksen taustalla on perusperiaate: tekoäly ei ole tuote. Lopputulos on tuote.
Käytännössä tämä tarkoittaa, että minkä tahansa tekoälyominaisuuden lähtökohta ei ole koskaan "mihin tämä malli pystyy?" Vaan "missä ihmiset käyttävät aikaansa päätöksiin, joita heidän ei pitäisi joutua tekemään?"
Tämä ero ohjaa kaikkea seuraavaa aina ongelman valinnasta siihen, miten ominaisuus tuodaan esiin käyttöliittymässä.
"Kun tiimit sanovat rakentavansa tekoälytuotetta, he yleensä tarkoittavat, että he ovat integroineet mallin, tuoneet sen käyttöliittymän kautta saataville ja saavuttaneet vahvat tarkkuusluvut. Mikään tästä ei kuitenkaan takaa arvoa. Käyttäjät eivät osta älykkyyttä. He ostavat helpotusta: toistuvasta työstä, epävarmuudesta ja toiminnan kitkasta," Anurag sanoo.
Vaikka malli näyttäisi testeissä erinomaiselta, todellinen testi on se, vaikuttaako se käyttäjien työskentelytapaan.
Want to learn more about Hiver?
Päättely vai säännöt: valitse ensin oikea työkalu
Ennen kuin mitään ongelmaa aletaan tarkastella mallin valinnan tai datan arvioinnin näkökulmasta, on esitettävä perustavanlaatuisempi kysymys: Vaatiiko tämä todella päättelyä?
Päättely tarkoittaa, että järjestelmän on yleistettävä sellaisista malleista, joita se ei ole nähnyt nimenomaisesti, ja tehtävä arvioita, joita ei voida täysin määritellä etukäteen.
Säännöt tarkoittavat, että logiikka voidaan kirjoittaa nimenomaisesti: jos X, niin Y. Nämä kaksi eivät ole keskenään vaihtokelpoisia, ja päättelyn käyttäminen tilanteessa, jossa säännöt riittäisivät, lisää kustannuksia, viivettä ja ennakoimattomuutta ilman hyötyä.
Kun Hiverin tiimi tarvitsi reitityksen tiettyjen asiakassegmenttien, kuten VIP-tilien, tiettyjen toimialojen tai tiettyjen toimialueiden, sähköposteille, ensimmäinen ajatus oli rakentaa tekoälymalli, joka tunnistaisi ne automaattisesti.
Sen sijaan Hiver rakensi määritettäviä sääntöobjekteja. Ne käyttävät toimialueisiin, avainsanoihin ja metatietoihin perustuvaa nimenomaista logiikkaa. Lopputulos on ennakoitava ja helposti vianmääritettävä, ja loppukäyttäjät voivat määrittää sen ilman Hiverin tekoälytiimin osallistumista.
Jos yritys esimerkiksi haluaa, että kaikki osoitteesta @enterprise.com tulevat sähköpostit tai sanan “sopimus” sisältävät viestit siirretään priorisoituun postilaatikkoon, se voi määrittää säännön muutamassa minuutissa. Tähän ei tarvita tekoälyä, eikä sähköpostien käsittelyssä ole epäselvyyttä.
Kuten Anurag asian ilmaisee: "Jos pystyt kirjoittamaan säännöt, kirjoita säännöt. Säästä tekoäly ongelmiin, joissa sääntöjä olisi mahdotonta luetella kattavasti ja joissa järjestelmän on yleistettävä sellaisista malleista, joita se ei ole nähnyt nimenomaisesti."
Päättelyä todella vaativien ongelmien arviointi
Kun ongelma todella vaatii päättelyä, Hiver arvioi sitä neljän kriteerin perusteella ennen rakentamiseen sitoutumista:
- Toistuvuus. Tekoälyllä on todellisia lisäkustannuksia: päättelykustannukset, lisääntynyt viive ja ennalta arvaamattomat vikatilanteet. Nämä lisäkustannukset ovat perusteltuja vain, kun tehtävä toistuu riittävän usein, jotta automaatio voi tuottaa kumulatiivista hyötyä. Muutaman kerran viikossa tapahtuva tehtävä harvoin oikeuttaa tähän monimutkaisuuteen. Tehtävä, jonka agentit suorittavat satoja kertoja päivässä, oikeuttaa.
- Ennustettavuus. Jotkin luokittelut riippuvat syötteessä olevista tiedoista (sähköpostin sisällöstä, aiherivistä ja metatiedoista) sen sijaan, että ne opittaisiin saatavilla olevasta datasta. Toiset taas riippuvat kontekstista, jota mallilla ei yksinkertaisesti ole: asiakastasosta, sisäisistä eskalointikäytännöistä tai ajan myötä kertyneestä agentin harkinnasta. Ennen kuin tiimi sitoutuu toteutukseen, se suorittaa historiallisella datalla toteutettavuustarkistuksia selvittääkseen, onko ennustaminen ylipäätään mahdollista hyödyllisellä varmuustasolla. Jos signaalia ei ole, mikään arkkitehtuuripäätös ei muuta sitä.
- Asiakkaiden kysyntä. Ratkaistaanko tällä ongelma, jonka asiakkaat ovat tuoneet esiin, vai ongelma, jonka tiimi on olettanut heidän kokevan? Ensimmäisessä tapauksessa käyttöönoton todennäköisyys on paljon suurempi. Jälkimmäinen johtaa yleensä ominaisuuksiin, jotka toimivat hyvin, mutta jotka sivuutetaan käyttöönoton yhteydessä.
- Panokset ja peruttavuus. Mitä tapahtuu, kun malli on väärässä? Väärin luokiteltu tunniste, jonka agentti korjaa yhdellä napsautuksella, sisältää aivan erilaisen riskiprofiilin kuin asiakkaalle lähetetty virheellinen vastaus tai väliin jäänyt eskalointi. Vähäisen riskin ja helposti peruttavat ennusteet sopivat hyvin automatisoitaviksi. Suurten panosten päätökset edellyttävät joko ihmisen tarkistusta tai huomattavasti korkeampia varmuuskynnyksiä ennen niiden käynnistymistä.
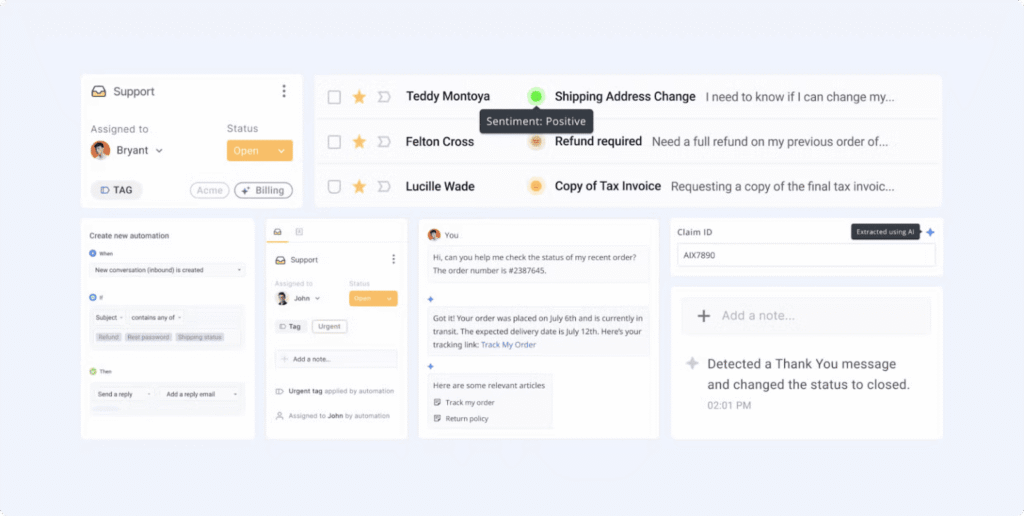
Hiverin automaattinen tunnisteiden lisäämisominaisuus toimii, koska se täyttää kaikki neljä kriteeriä. Se käyttää mallia päätelläkseen saapuvalle keskustelulle olennaisimman tunnisteen. Agenttien ei tarvitse luokitella jokaista tikettiä manuaalisesti.
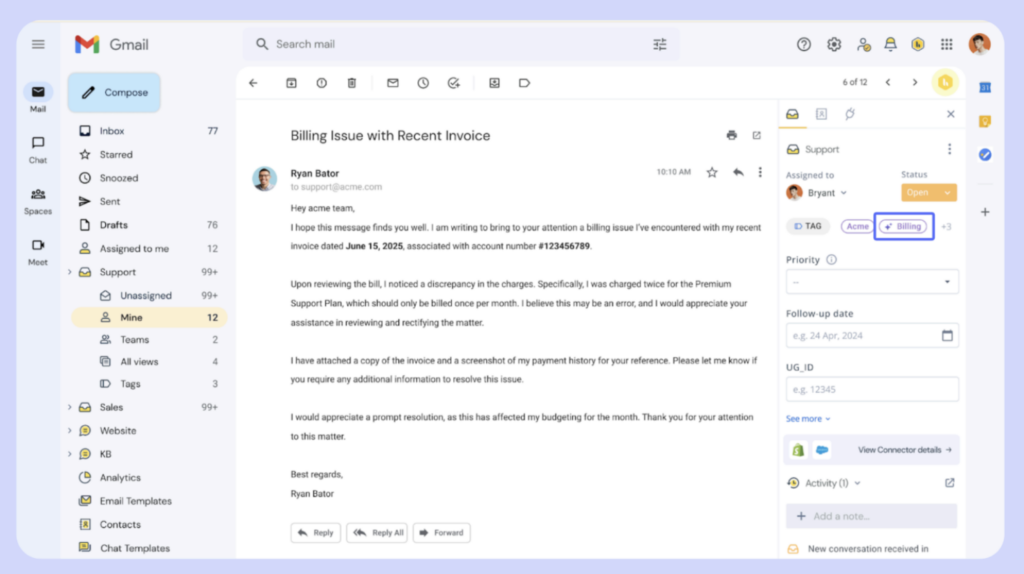
Tiimit määrittelevät hallintapaneelissa joukon tunnisteita, kuten “Laskutus” tai “Tekninen tuki.” Nämä toimivat ennustamisen kohteina. Malli oppii sähköpostin sisällöstä, aiherivistä ja metatiedoista löytyviä malleja. Mukaan otetaan vain tunnisteet, joihin liittyy selkeitä signaaleja.
Agentit suorittavat tämän tehtävän lähes jokaisen keskustelun yhteydessä, mikä tekee siitä usein toistuvan. Mukaan otettujen tunnisteiden signaali on läsnä sähköpostin sisällössä, mikä tekee tehtävästä ennustettavan. Hiverin asiakkaat ovat pyytäneet nimenomaisesti manuaalisen lajittelun vähentämistä, mikä edistää käyttöönottoa. Kun malli on väärässä, tunniste voidaan korjata yhdellä napsautuksella, mikä pitää panokset vähäisinä ja tilanteen helposti peruttavana.
Tunneanalyysi noudattaa samaa mallia. Se analysoi jokaisen keskustelun sävyä selvittääkseen, onko asiakas turhautunut, neutraali vai myönteinen. Tiimit näkevät tämän jokaisessa keskustelussa, joten kyseessä on usein toistuva tehtävä. Sävy on läsnä tekstissä, mikä tekee siitä ennustettavan.
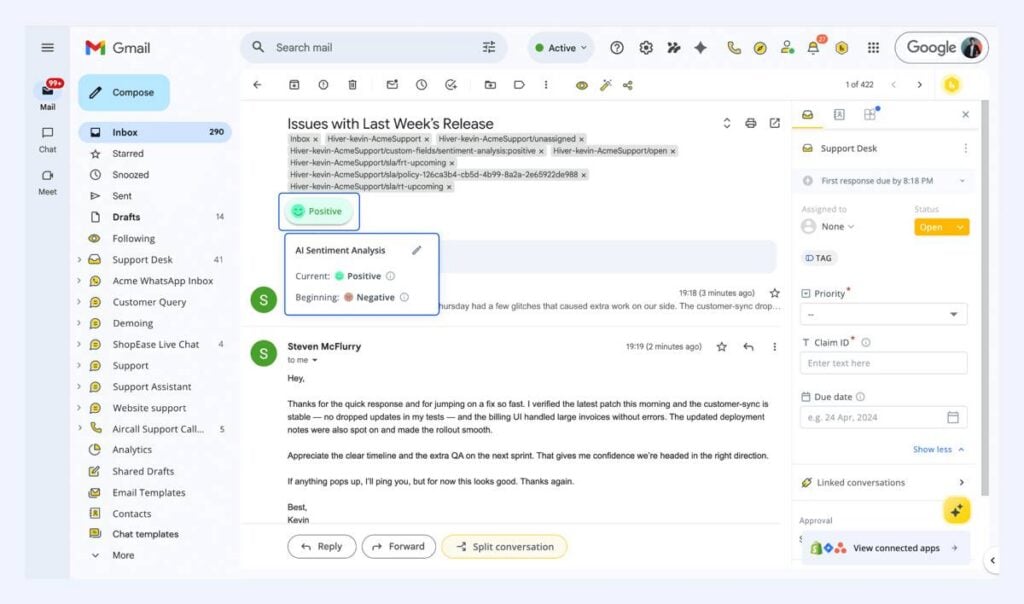
Tiimit haluavat saada varhaisessa vaiheessa näkyvyyttä turhautuneisiin asiakkaisiin, mikä luo selkeää kysyntää. Jos malli on väärässä, agentit voivat ohittaa sen vaikuttamatta lopputulokseen, mikä pitää riskin vähäisenä.
Toteutettavuuden testaaminen ennen rakentamista
Yksi Hiverin prosessin kurinalaisuutta eniten vaativista osista on tarkkuuden toteutettavuustestien suorittaminen ennen tuotantokoodin kirjoittamista.
Tunniste-ehdotusominaisuus on valaiseva esimerkki. Jos sähköpostissa esimerkiksi lukee “Minulta veloitettiin kahdesti,” mallin pitäisi valita “Laskutus.” Se yritti kuitenkin valita myös tunnisteita, kuten “VIP-asiakas” tai “Eskaloi esihenkilölle,” joita ei voi päätellä itse sähköpostista. Täsmällisyys oli heikko, ja agentit lakkasivat luottamasta tulokseen.
Taustalla oleva ongelma oli ennustettavien ja ennustamattomien tunnistetyyppien erottamatta jättäminen. Luokittelutunnisteet, kuten "Laskutus," "Tekninen tuki," ja "Palautukset", vastaavat sähköpostin sisällössä esiintyviä kielellisiä malleja. Ne ovat opittavissa.
Operatiiviset tunnisteet, kuten "VIP-asiakas," "Odottaa lakiosastoa," ja "Eskaloi esihenkilölle", riippuvat syötteen ulkopuolisesta kontekstista: asiakashistoriasta, sisäisistä liiketoimintasäännöistä ja tiimien välisestä koordinoinnista. Mikään asiakassähköposteilla koulutettu malli ei pysty ennustamaan niitä luotettavasti.
Ratkaisu oli rakenteellinen: ennen kuin mikä tahansa tunnistetyyppi otetaan ennustamisen kohteeksi, se käy läpi toteutettavuustarkistuksen. Tukeeko historiallinen data tämän tuloksen luotettavaa ennustamista? Jos ei, se rajataan mallin ulkopuolelle riippumatta siitä, kuinka hyödyllistä kyseisen tunnisteen automatisointi teoriassa olisi.
"Sen myöntäminen, että 'tämä tunnistetyyppi ei sovellu hyvin automatisoitavaksi', oli vaikeampaa kuin mallin rakentaminen. Mutta sen ansiosta julkaisimme vain ennusteita, joihin agentit saattoivat luottaa."
Tekoälyn upottaminen työnkulkuun, ei sen päälle
Sillä, missä tekoäly sijaitsee tuotteessa, on yhtä suuri merkitys kuin sillä, mitä se tekee.
Ominaisuus, joka saa käyttäjät pysähtymään, kirjoittamaan kehotteen ja tarkistamaan tuloksen ennen toimimista, on lisännyt työnkulkuun vaiheen sen sijaan, että olisi poistanut sellaisen. Lopputulos on kielteinen, vaikka tekoäly olisi tarkka. Käyttäjät, jotka työskentelevät nopeasti ja käsittelevät tikettejä yksi toisensa jälkeen, kiertävät kaiken, mikä keskeyttää tämän rytmin.
Toimiva suunnittelusuunta on tekoäly, joka toimii ennen kuin käyttäjän tarvitsee ajatella asiaa. Hiverissä:
- Sähköpostit merkitään tunnisteilla ennen kuin asiakaspalvelijat avaavat ne.
- Tunneanalyysi lasketaan ja merkitään ennen kuin asiakaspalvelija avaa keskustelun: turhautunut asiakas on jo nostettu jonon kärkeen.
- Jonon järjestys heijastaa prioriteettisignaaleja ilman, että asiakaspalvelijoiden tarvitsee määrittää mitään.
- Vastausluonnokset näkyvät suoraan ehdotuksina.
- Tapaukset, joissa mallin luottamus alittaa tietyn raja-arvon, ohjataan ihmisen tarkistettaviksi sen sijaan, että mitään toimia tehtäisiin automaattisesti.
Käyttöliittymää ei ole rakennettu sen ympärille, että tekoälyltä pyydetään apua. Asiakaspalvelijoiden ei tarvitse käynnistää sitä. Sähköpostit merkitään tunnisteilla ja priorisoidaan ennen kuin he avaavat ne. Tekoäly vähentää vaivaa jo ennen kuin asiakaspalvelijan tarvitsee ajatella asiaa.
Sisäinen mittari sille, toimiiko tämä: "Jos käyttäjät huomaavat tekoälyn, olet todennäköisesti rakentanut sen väärin."
Kun se toimii, käyttäjät lakkaavat mainitsemasta tekoälyominaisuutta. He puhuvat nopeammista ratkaisuajoista, pienemmästä työjonosta ja uusien asiakaspalvelijoiden helpommasta perehdyttämisestä. Tekoäly on siirtynyt näkyvästä rakenteelliseksi osaksi toimintaa.
| 📌 Asiakasesimerkki: Miltä tämä näyttää käytännössä |
|---|
| 📌 Asiakasesimerkki: Miltä tämä näyttää käytännössäITS Logisticsilla tiimit hallinnoivat asiakasviestintää hajallaan olevissa postilaatikoissa, ohjasivat pyyntöjä manuaalisesti ja astuivat usein toistensa varpaille päällekkäisten vastausten tai väliin jääneiden seurantatoimien vuoksi. Hiveriin siirtymisen jälkeen tilanne muuttui nopeasti. Jo kolmessa viikossa tarjousten käsittelyaika lyheni 61 %, ja useimmat saapuvat pyynnöt ohjautuivat automaattisesti oikealle henkilölle. Vielä tärkeämpää oli, että jokaisella keskustelulla oli selkeä vastuuhenkilö ja esihenkilöt saivat vihdoin näkyvyyden työn etenemiseen. Tuloksena oli järjestelmä, joka pystyi käsittelemään kasvavaa kysyntää lisäämättä monimutkaisuutta tai henkilöstömäärää, koska työstä itsestään tuli jäsennellympää ja ennakoitavampaa. “Hiver muutti hajallaan olevat kyselyt jäsennellyksi asiakaspalvelujärjestelmäksi. Jokainen pyyntö seurataan, sillä on vastuuhenkilö ja se ratkaistaan nopeammin.” — Alejandro Arboleda, operatiivinen johtaja, ITS Logistics. |
Tarkkuus ja luottamus ovat eri ongelmia
Järjestelmä voi saavuttaa 95 prosentin tarkkuuden ja silti epäonnistua tuotannossa, jos käyttäjillä ei ole luotettavaa käsitystä siitä, milloin se tekee virheen.
Luottamus syntyy ennakoitavuudesta ja hallinnasta. Käyttäjien on ymmärrettävä järjestelmän toimintaa riittävästi tietääkseen, milloin siihen voi luottaa ja milloin sen ehdotus on ohitettava. Jos he eivät pysty muodostamaan tällaista käsitystä, he joko lopettavat ominaisuuden käytön tai lakkaavat tarkistamasta sen tuottamia tuloksia. Molemmat ovat epäonnistumisen muotoja.
Hiverin lähestymistavassa korjaaminen on olennainen osa suunnittelua eikä pelkkä virheiden varalle tarkoitettu varatoiminto. Asiakaspalvelijat voivat ohittaa minkä tahansa ennusteen yhdellä napsautuksella. Järjestelmä tallentaa muokkaukset palautesignaaliksi. Luottamukseen perustuvat raja-arvot määrittävät, mikä otetaan käyttöön automaattisesti ja mikä tuodaan tarkistettavaksi.
Anuragin sanoin: "Sen sijaan, että olisimme kohdelleet ohituksia epäonnistumisina, rakensimme ne ominaisuuksiksi. Näin asiakaspalvelijat pysyvät hallinnassa ja syntyy oppimissykli ilman, että koulutamme järjestelmää koskaan asiakasdatan avulla. Järjestelmä kehittyy tuloksia havainnoimalla."
Tämä ratkaisee myös dataan liittyvän ongelman. Koska korjaukset palaavat palautesignaalina, malli kehittyy havaittujen tulosten perusteella eikä tarvitse pääsyä asiakkaiden raakadataan.
Yksityisyyden raja säilyy ennallaan samalla, kun järjestelmä tarkentuu ajan myötä.
Kaksi kysymystä ennen minkä tahansa tekoälyominaisuuden julkaisua
Ennen kuin uudelle tekoälyominaisuudelle annetaan hyväksyntä, on kysyttävä kaksi kysymystä:
"Valittaisivatko käyttäjät, jos tämä ominaisuus poistettaisiin huomenna?"
Jos vastaus on ei, ominaisuus on hyödyllinen lisä, mutta ei välttämätön. Se ei ole vielä muuttanut ihmisten työskentelytapaa. Tätä tavoitetasoa kohti kannattaa rakentaa.
"Vähentääkö tämä ominaisuus yhtä päätöstä vai luoko se uuden päätöksen?"
Jos käyttäjien on ennen toimimista päätettävä, luottavatko he tekoälyyn, määritettävä sen asetukset tai tulkittava sen tuottama tulos, tekoäly on lisännyt kognitiivista kuormitusta sen sijaan, että se olisi vähentänyt sitä.
Se on epäonnistuminen teknisestä suorituskyvystä riippumatta.
Tekoälyominaisuuksien taustalla oleva varsinainen työ
Tuotannossa toimivan tekoälyn rakentamisessa on vähemmän kyse mallin valinnasta ja enemmän ongelman valinnasta, toteutettavuuden testaamisesta ja suunnittelusta ihmisten todellisten työskentelytapojen mukaan. Tekoäly itsessään on ongelman pienin osa.
"Tuote ei koskaan ollut luokittelu, tunneanalyysi, luonnosten laatiminen tai tiivistäminen. Tuote oli asiakaspalvelijakohtaisten päätösten vähentäminen, nopeammat tulokset, pienempi kognitiivinen kuormitus ja skaalautuva toiminta. Tekoäly oli väline, ja väline toimii vain, kun sitä sovelletaan oikeaan ongelmaan datalla, joka todella tukee ratkaisua."
Jos pohdit, miten tekoäly sopii asiakastukesi toimintaan, keskustele kanssamme Hiverillä. Näytämme, miten voimme auttaa sinua tarjoamaan empaattista tukea.