Inzichten van Hivers hoofd AI
De meeste mensen gaan ervan uit dat het bouwen van AI-functies voor een klantenserviceplatform alleen draait om planning, uitvoering en oplevering.
Maar als je praat met de mensen achter de schermen, weet je hoe anders de werkelijkheid echt is.
Anurag Maherchandani, hoofd AI bij Hiver, is een van die mensen. Bij Hiver, een AI-aangedreven klantenserviceplatform dat door meer dan 10.000 supportteams wordt gebruikt om klantgesprekken op schaal af te handelen, kwam de druk om "AI toe te voegen" vroeg en hard aan. Elke inbox, elk ticket en elke klantinteractie leek een natuurlijke kandidaat voor automatisering.
Anurag leidt alle AI-initiatieven van Hiver, wat betekent dat hij verantwoordelijk is voor het bepalen wat er gebouwd moet worden, hoe dat moet gebeuren en waarom het belangrijk zou moeten zijn voor klanten. Dit is zijn visie op wat er echt nodig is om goed werkende AI-functies te bouwen.
Begin met het resultaat, niet met het model
Het kernprincipe achter elke AI-beslissing bij Hiver: AI is niet het product. Het resultaat is het product.
In de praktijk betekent dit dat het uitgangspunt voor elke AI-functie nooit "wat kan dit model doen?" is. Het is "waar besteden mensen tijd aan beslissingen die ze niet zouden hoeven nemen?"
Dat onderscheid bepaalt alles wat volgt, van de keuze van het probleem tot de manier waarop de functie in de gebruikersinterface wordt aangeboden.
"Wanneer teams zeggen dat ze 'een AI-product bouwen', bedoelen ze meestal dat ze een model hebben geïntegreerd, dit via een gebruikersinterface beschikbaar hebben gemaakt en sterke nauwkeurigheidscijfers hebben behaald. Maar niets daarvan garandeert waarde. Gebruikers kopen geen intelligentie. Ze kopen verlichting: van repetitief werk, van onzekerheid en van operationele frictie," zegt Anurag.
Zelfs als een model er tijdens het testen geweldig uitziet, is de echte lakmoesproef of het de manier waarop gebruikers werken beïnvloedt.
Inferentie of regels: kies eerst het juiste hulpmiddel
Voordat een probleem in de fase van modelselectie of gegevensbeoordeling terechtkomt, is er een fundamentelere vraag: Is hiervoor daadwerkelijk inferentie nodig?
Inferentie betekent dat het systeem moet generaliseren op basis van patronen die het niet expliciet eerder heeft gezien en beslissingen moet nemen die niet volledig vooraf kunnen worden vastgelegd.
Regels betekenen dat de logica expliciet kan worden geschreven: als X, dan Y. De twee zijn niet uitwisselbaar, en inferentie gebruiken wanneer regels zouden volstaan, brengt kosten, latentie en onvoorspelbaarheid met zich mee zonder enig voordeel.
Toen het team bij Hiver routering moest instellen voor e-mails van specifieke klantsegmenten, zoals VIP-accounts, bepaalde bedrijfstakken of specifieke domeinen, was het eerste idee om een AI-model te bouwen dat deze automatisch kon identificeren.
In plaats daarvan bouwde Hiver configureerbare regelobjecten. Deze gebruiken expliciete logica op basis van domeinen, trefwoorden en metagegevens. Het resultaat is voorspelbaar, eenvoudig te debuggen en configureerbaar door eindgebruikers zonder dat het AI-team van Hiver erbij betrokken hoeft te worden.
Als een bedrijf bijvoorbeeld alle e-mails van @enterprise.com of berichten met het woord “contract” naar een prioriteitsinbox wil sturen, kan het in enkele minuten een regel instellen. Hiervoor is geen AI nodig en er bestaat geen onduidelijkheid over de manier waarop e-mails worden verwerkt.
Zoals Anurag het verwoordt: "Als je de regels kunt opschrijven, schrijf dan de regels. Bewaar AI voor problemen waarbij het onmogelijk zou zijn om alle regels op te sommen en waarbij je het systeem moet laten generaliseren op basis van patronen die het niet expliciet eerder heeft gezien."
Problemen beoordelen waarvoor wel inferentie nodig is
Zodra een probleem daadwerkelijk inferentie vereist, beoordeelt Hiver het aan de hand van vier criteria voordat het besluit het te bouwen:
- Frequentie. AI brengt echte overhead met zich mee: inferentiekosten, extra latentie en onvoorspelbare foutmodi. Die overhead is alleen zinvol wanneer de taak vaak genoeg voorkomt om automatisering te laten renderen. Een taak die een paar keer per week voorkomt, rechtvaardigt de complexiteit zelden. Een taak die agents honderden keren per dag uitvoeren wel.
- Voorspelbaarheid. Sommige classificaties zijn afhankelijk van informatie die in de invoer aanwezig is (e-mailinhoud, onderwerpregel, metagegevens), in plaats van dat ze worden geleerd uit beschikbare gegevens. Andere zijn afhankelijk van context waarover het model simpelweg niet beschikt: klantniveau, interne escalatieprocedures, het oordeel van agents dat in de loop der tijd is opgebouwd. Voordat het team besluit iets te bouwen, voert het haalbaarheidscontroles uit op historische gegevens om te bepalen of een voorspelling überhaupt mogelijk is met een bruikbaar betrouwbaarheidsniveau. Als het signaal ontbreekt, verandert geen enkele architectuurbeslissing daar iets aan.
- Klantvraag. Lost dit een probleem op dat klanten hebben benoemd, of een probleem waarvan het team heeft aangenomen dat ze het hebben? Bij het eerste is de kans op gebruik veel groter. Het tweede leidt vaak tot functies die goed werken, maar worden genegeerd wanneer het op gebruik aankomt.
- Risico's en omkeerbaarheid. Wat gebeurt er wanneer het model het bij het verkeerde eind heeft? Een verkeerd toegewezen tag die een agent met één klik corrigeert, heeft een heel ander risicoprofiel dan een verkeerd verstuurd antwoord aan een klant of een gemiste escalatie. Voorspellingen met lage inzet die eenvoudig kunnen worden teruggedraaid, zijn sterke kandidaten voor automatisering. Beslissingen met grote gevolgen vereisen menselijke controle of aanzienlijk hogere betrouwbaarheidsdrempels voordat ze worden geactiveerd.
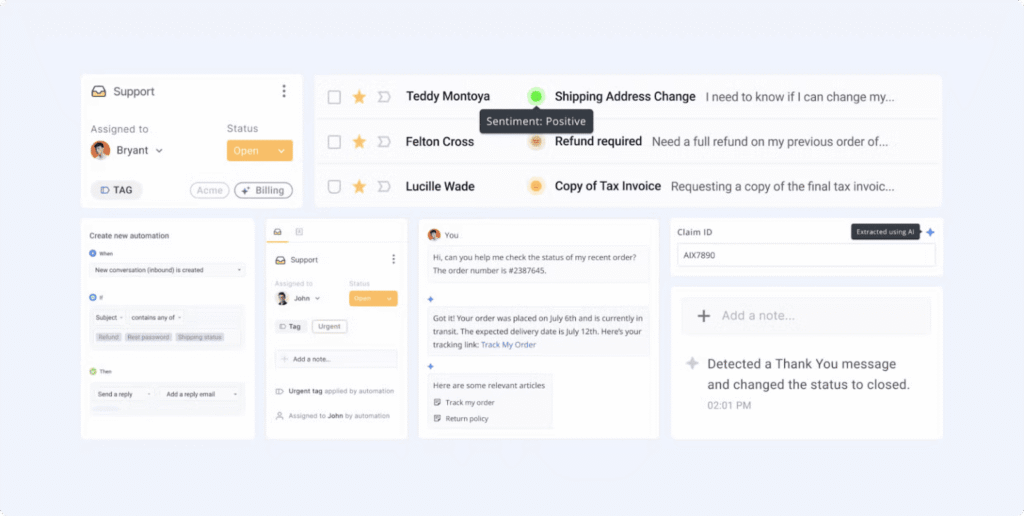
De functie voor automatisch taggen van Hiver werkt omdat deze aan alle vier de criteria voldoet. De functie gebruikt een model om de meest relevante tag voor een binnenkomend gesprek af te leiden. Agents hoeven niet elk ticket handmatig te categoriseren.
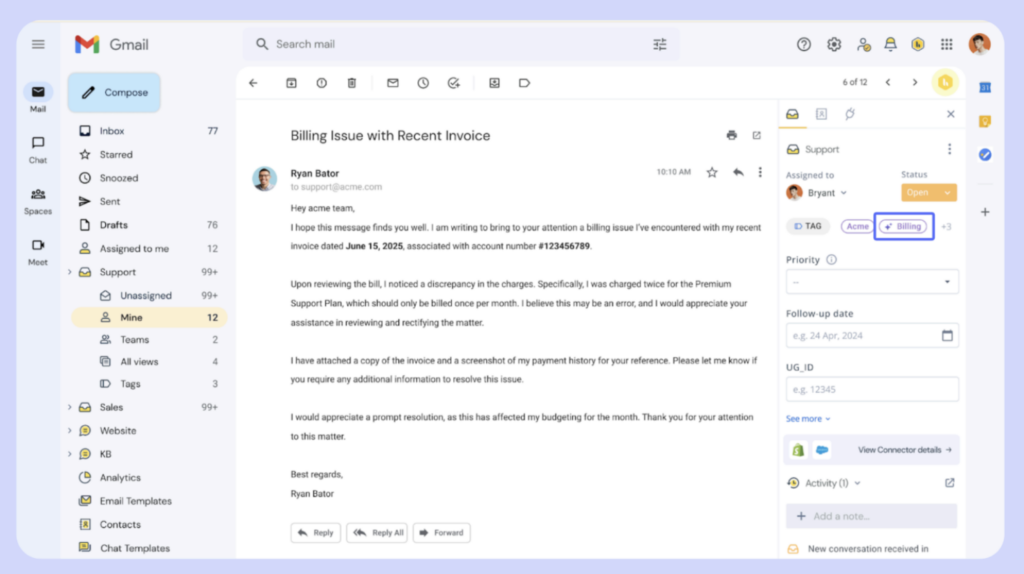
Teams definiëren een reeks tags in het beheerpaneel, zoals “Facturering” of “Technische ondersteuning.” Deze dienen als de voorspellingsdoelen. Het model leert patronen uit de e-mailinhoud, onderwerpregel en metagegevens. Alleen tags met duidelijke signalen worden opgenomen.
Agents voeren deze taak bij bijna elk gesprek uit, waardoor de frequentie hoog is. Het signaal is aanwezig in de e-mailinhoud voor de opgenomen tags, waardoor het voorspelbaar is. Klanten van Hiver hebben expliciet gevraagd om handmatige triage te verminderen, wat de acceptatie stimuleert. Wanneer het model zich vergist, kan de tag met één klik worden gecorrigeerd, waardoor de inzet laag en omkeerbaar blijft.
Sentimentanalyse volgt hetzelfde patroon. Hierbij wordt de toon van elk gesprek geanalyseerd om vast te stellen of een klant gefrustreerd, neutraal of positief is. Teams zien dit bij elk gesprek, dus de frequentie is hoog. De toon is aanwezig in de tekst, waardoor deze voorspelbaar is.
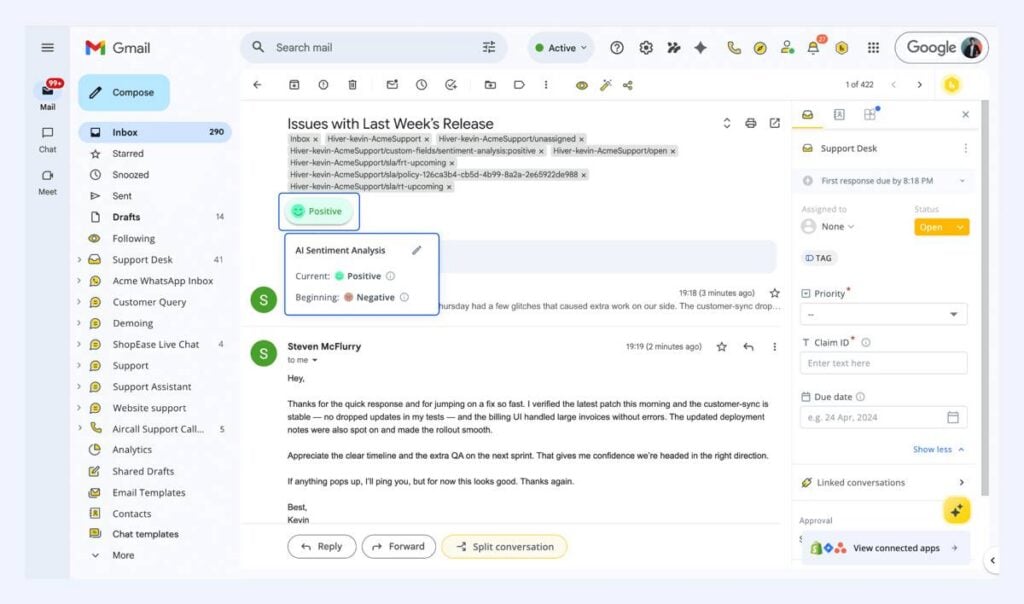
Teams willen vroeg inzicht in gefrustreerde klanten, wat een duidelijke vraag creëert. Als het model zich vergist, kunnen agents de uitkomst overschrijven zonder het resultaat te beïnvloeden, waardoor het risico laag blijft.
Haalbaarheidstesten vóór het bouwen
Een van de meest discipline-intensieve onderdelen van Hivers proces: nauwkeurigheidstests voor de haalbaarheid uitvoeren voordat er productiecode wordt geschreven.
De functie voor tagsuggesties is een leerzaam voorbeeld. Als een e-mail bijvoorbeeld zegt: “Er is twee keer bij mij afgeschreven,” moet het model “Facturering.” kiezen. Het probeerde echter ook tags te kiezen zoals “VIP-klant” of “Escaleren naar manager,” die niet uit de e-mail zelf kunnen worden afgeleid. De precisie was slecht en agents vertrouwden de uitvoer niet langer.
Het onderliggende probleem was dat er geen onderscheid werd gemaakt tussen voorspelbare en onvoorspelbare typen tags. Categorietags zoals "Facturering," "Technische ondersteuning," en "Retouren" zijn te koppelen aan taalpatronen in e-mailinhoud. Ze zijn aan te leren.
Operationele tags zoals "VIP-klant," "Wachten op juridische goedkeuring," en "Escaleren naar manager" zijn afhankelijk van context buiten de invoer: accountgeschiedenis, interne bedrijfsregels en coördinatie tussen teams. Geen enkel model dat op klant-e-mails is getraind, zal deze betrouwbaar voorspellen.
De oplossing was structureel: voordat een type tag als voorspellingsdoel wordt opgenomen, wordt het aan een haalbaarheidscontrole onderworpen. Ondersteunen historische gegevens een betrouwbare voorspelling van deze uitkomst? Zo niet, dan wordt het type uitgesloten van de reikwijdte van het model, ongeacht hoe nuttig het automatiseren van die tag theoretisch zou zijn.
"De discipline om te zeggen 'dit type tag is geen goede kandidaat voor automatisering' was moeilijker dan het bouwen van het model. Maar daardoor brachten we alleen voorspellingen uit die agents konden vertrouwen."
AI in de workflow integreren, niet erbovenop plaatsen
Waar AI zich in het product bevindt, is net zo belangrijk als wat het doet.
Een functie die gebruikers laat stoppen, een prompt laat typen en de uitvoer laat controleren voordat ze actie ondernemen, heeft een stap aan de workflow toegevoegd in plaats van er een te verwijderen. Dat is per saldo negatief, zelfs wanneer de AI nauwkeurig is. Gebruikers die snel werken en ticket na ticket afhandelen, zullen alles omzeilen wat dat ritme onderbreekt.
De ontwerpbenadering die werkt: AI die handelt voordat de gebruiker erover hoeft na te denken. Bij Hiver:
- E-mails worden getagd voordat medewerkers ze openen.
- Het sentiment wordt berekend en gemarkeerd voordat een medewerker het gesprek opent: een gefrustreerde klant staat al bovenaan de wachtrij.
- De volgorde van de wachtrij weerspiegelt prioriteitssignalen zonder dat medewerkers iets hoeven te configureren.
- Antwoordconcepten verschijnen inline als suggesties.
- Zaken waarbij het vertrouwen van het model onder een bepaalde drempel komt, worden ter beoordeling aan een medewerker voorgelegd in plaats van dat er automatisch actie wordt ondernomen.
De interface is niet ontworpen rondom het vragen om hulp aan AI. Medewerkers hoeven de functie niet te activeren. E-mails worden getagd en geprioriteerd voordat ze deze openen. De AI neemt werk uit handen voordat de medewerker erover hoeft na te denken.
De interne maatstaf voor de vraag of dit werkt: "Als gebruikers de AI opmerken, heb je het waarschijnlijk verkeerd gebouwd."
Wanneer het werkt, noemen gebruikers de AI-functie niet meer. Ze noemen kortere afhandelingstijden, een kleinere achterstand en een eenvoudigere inwerkperiode voor nieuwe medewerkers. De AI is van zichtbaar naar structureel gegaan.
| 📌 Klantmomentopname: zo ziet dit er in de praktijk uit |
|---|
| 📌 Klantmomentopname: zo ziet dit er in de praktijk uitBij ITS Logistics beheerden teams klantgesprekken via verspreide inboxen, routeerden ze verzoeken handmatig en liepen ze elkaar vaak voor de voeten met dubbele antwoorden of gemiste opvolging. Na de overstap naar Hiver veranderde dat snel. Binnen slechts drie weken daalde de doorlooptijd voor offertes met 61% en werden de meeste binnenkomende verzoeken automatisch naar de juiste persoon gerouteerd. Nog belangrijker: elk gesprek had een duidelijke eigenaar en managers kregen eindelijk inzicht in de voortgang van het werk. Het resultaat was een systeem dat een groeiende vraag kon verwerken zonder extra complexiteit of personeel, omdat het werk zelf gestructureerder en voorspelbaarder werd. “Hiver veranderde verspreide vragen in een gestructureerd klantenservicesysteem. Elk verzoek wordt bijgehouden, toegewezen en sneller opgelost.” — Alejandro Arboleda, Operations Director, ITS Logistics. |
Nauwkeurigheid en vertrouwen zijn verschillende problemen
Een systeem kan een nauwkeurigheid van 95% behalen en in productie toch falen als gebruikers geen betrouwbaar mentaal model hebben van de momenten waarop het systeem fouten maakt.
Vertrouwen komt voort uit voorspelbaarheid en controle. Gebruikers moeten het gedrag van het systeem goed genoeg begrijpen om te weten wanneer ze erop kunnen vertrouwen en wanneer ze het moeten negeren. Als ze dat model niet kunnen ontwikkelen, stoppen ze óf met het gebruiken van de functie óf met het controleren van de uitvoer, en beide zijn vormen van falen.
Hivers aanpak is om correctie een kernelement van het ontwerp te maken in plaats van een terugvaloptie voor fouten. Medewerkers kunnen elke voorspelling met één klik overschrijven. Het systeem legt wijzigingen vast als feedbacksignalen. Drempelwaarden op basis van vertrouwen bepalen wat automatisch wordt toegepast en wat ter beoordeling wordt voorgelegd.
In de woorden van Anurag: "In plaats van overschrijvingen als fouten te beschouwen, hebben we ze als functies ontworpen. Zo houden medewerkers de controle en ontstaat er een leercyclus zonder dat we ooit trainen op klantgegevens. Het systeem wordt beter door resultaten te observeren."
Dit lost ook een dataprobleem op. Omdat correcties als feedbacksignalen terugvloeien, verbetert het model op basis van waargenomen resultaten, zonder toegang tot onbewerkte klantgegevens te vereisen.
De privacygrens blijft intact terwijl het systeem na verloop van tijd nauwkeuriger wordt.
Twee vragen voordat een AI-functie wordt uitgebracht
Voordat een nieuwe AI-functie wordt goedgekeurd, zijn er twee vragen:
"Zouden gebruikers klagen als deze functie morgen werd verwijderd?"
Als het antwoord nee is, voegt de functie wel iets toe, maar is ze niet essentieel. Ze heeft nog niet veranderd hoe mensen werken. Dat is de norm om naartoe te werken.
"Vermindert deze functie een beslissing, of creëert ze een nieuwe?"
Als gebruikers moeten beslissen of ze de AI vertrouwen, de AI moeten configureren of de uitvoer ervan moeten interpreteren voordat ze kunnen handelen, heeft de AI cognitieve belasting toegevoegd in plaats van die weg te nemen.
Dat is een mislukking, ongeacht de technische prestaties.
Het echte werk achter AI-functies
AI bouwen die in productie werkt, draait minder om modelselectie en meer om probleemselectie, haalbaarheidstests en ontwerpen voor de manier waarop mensen daadwerkelijk werken. De AI zelf is het kleinste deel van het probleem.
"Het product was nooit classificatie, sentimentanalyse, opstellen of samenvatten. Het product bestond uit minder beslissingen per medewerker, snellere resultaten, minder cognitieve belasting en schaalbare activiteiten. AI was het mechanisme, en een mechanisme werkt alleen wanneer het wordt toegepast op het juiste probleem, met gegevens die de oplossing daadwerkelijk ondersteunen."
Als je nadenkt over waar AI binnen je supportactiviteiten past, praat met ons bij Hiver. We laten je zien hoe we je kunnen helpen empathische ondersteuning te bieden.