

Du ved måske allerede, at sentimentanalyse bruges til at afgøre, om et stykke data har en neutral, positiv eller negativ holdning. Men eftersom du er her, er det sandsynligt, at du ikke har en meget dybere forståelse end det.
I denne artikel besvarer jeg spørgsmålene: Hvad er sentimentanalyse? Hvordan fungerer sentimentanalyse? Og hvad kan sentimentanalyse gøre for dig?
Når du har fået styr på det hele, kan du gå videre og se vores liste over de 10 bedste værktøjer til sentimentanalyse.
Hvad er sentimentanalyse?
Før vi går i dybden, får du her en kort opsummering af, hvad sentimentanalyse er.
Som mennesker bruger vi sentimentanalyse dagligt til at vurdere hinandens holdninger. Nogle gange kan det være svært, f.eks. når man har med en særligt sarkastisk ven at gøre eller forsøger at finde ud af, hvad ens chef virkelig mener, når vedkommende giver feedback på en stor præsentation! Software til sentimentanalyse forsøger at efterligne denne meget menneskelige oplevelse.
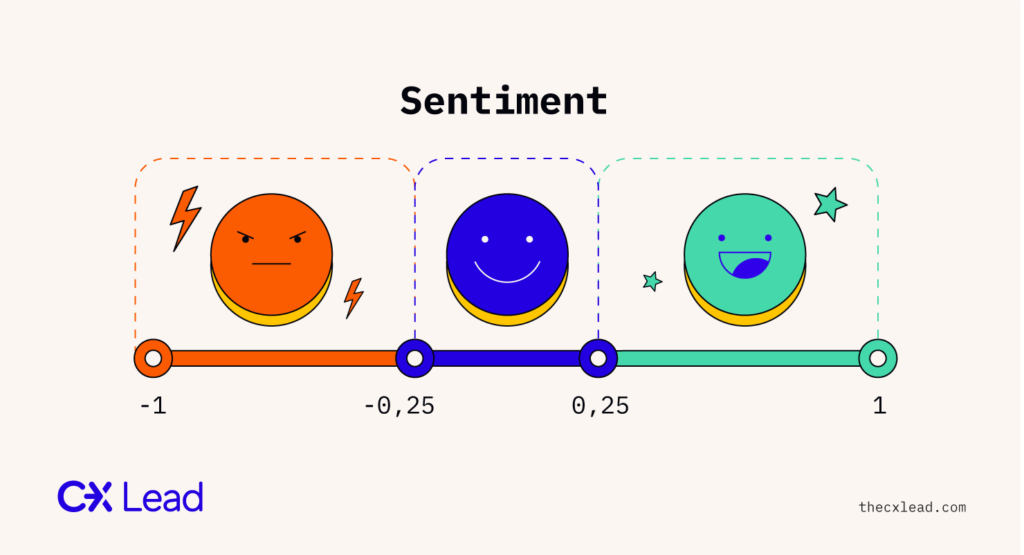
Selvom noget software kan analysere tale, bruges de fleste værktøjer til sentimentanalyse til tekstanalyse for at klassificere den overordnede holdning i et stykke tekst som positiv, negativ eller neutral. Dette kaldes polaritet.
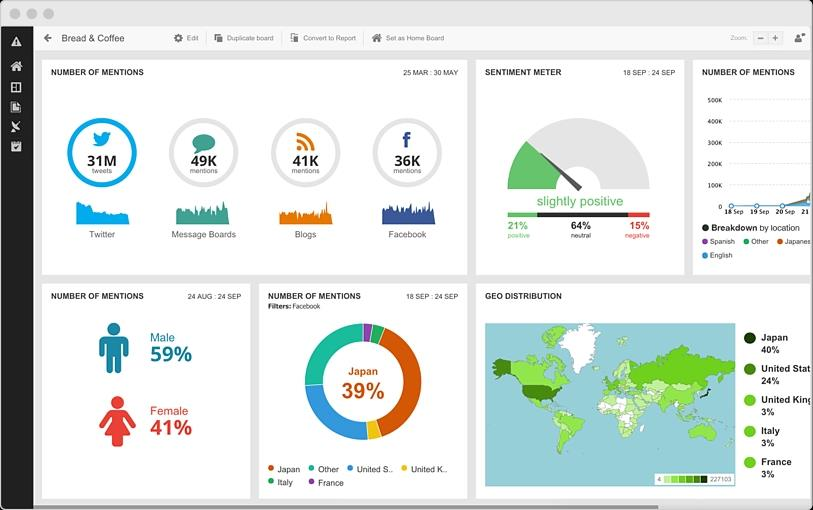
Almindelige datakilder til sentimentanalyse er opslag på sociale medier, nyhedsartikler, onlineanmeldelser, feedbackformularer, der er udsendt for at indhente svar, undersøgelsessvar, websider/blogs/fora. Du kan også høre sentimentanalyse omtalt som holdningsudvinding, følelsesbaseret AI eller, mere teknisk, holdningsklassifikation.
Der er fire hovedtyper af sentimentanalyse:
- Finkornet, også kaldet polaritet (positiv, negativ eller neutral)
- Følelser og emotioner (glad, vred, trist, underholdt)
- Aspektbaseret (identificerer en holdning til et specifikt aspekt af noget, f.eks. kameraet på en smartphone)
- Intention (interesseret, ikke interesseret, meget interesseret).
Værktøjer til sentimentanalyse hjælper dig med at gennemgå den enorme mængde subjektive data, der findes på Web 2.0, for at forstå feedback fra interessenter.
Organisationer anvender sentimentanalyse på en række forskellige måder. Mange brands bruger det som en del af deres markedsundersøgelser for bedre at forstå, hvad der fungerer godt i deres brandstrategi, og hvor de har brug for at forbedre sig. En anden anvendelse er, at finansielle institutioner analyserer nyhedscyklussen og identificerer investeringsmuligheder.
Hvordan fungerer sentimentanalyse?
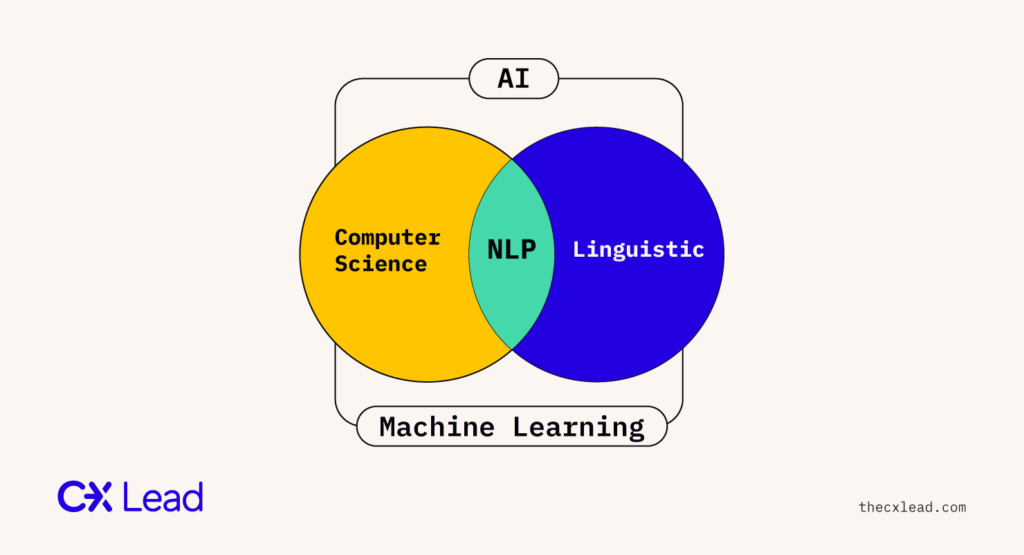
OK, lad os nu se nærmere på mekanikken bag, hvordan sentimentanalyse faktisk fungerer. I sin kerne er sentimentanalyse en form for datavidenskab. Mere specifikt er det en form for behandling af naturligt sprog (NLP), som selv er en undergren af kunstig intelligens (AI), der bruges til at identificere og klassificere subjektive holdninger ud fra tekst- eller taledata.
AI i sentimentanalyse af kunder befinder sig lige i krydsfeltet mellem computerteknologi og menneskelig tale, hvilket er spændende for enhver dataforsker med kærlighed til lingvistik.
Men det er ikke nemt. For at forstå sproget i en tekst korrekt og producere en præcis sentimentscore eller meningsfuld indsigt skal programmer anvende en række metoder, der simulerer det, vi mennesker gør intuitivt. Disse simuleringer tager form af avancerede algoritmer (instruktioner til computere).
Herfra er der to hovedtilgange til sentimentanalyse:
- Regelbaseret: et system baseret på regler, der er fastlagt manuelt af mennesker.
- Automatisk: systemer, der lærer selv ved hjælp af avancerede maskinlæringsteknikker.
Den grundlæggende forskel mellem de to er deres tilgang til at lære systemet op. Nu gennemgår vi disse lidt mere detaljeret.
Have an account? Log In
Regelbaseret sentimentanalyse
Den regelbaserede metode bruger NLP sammen med et sæt manuelt definerede regler til at identificere subjektivitet, polaritet eller emnet for en holdning. Nogle af de anvendte NLP-teknikker er ordstammeudledning, tokenisering, ordklassemarkering, syntaktisk analyse og leksikalsk analyse. Hvis du er interesseret, kan du læse mere om disse her.
Her er et grundlæggende eksempel på eller en regelbaseret sentimentanalyse.
For at bestemme polariteten i et stykke tekst skal sentimentanalyseværktøjer først opdele det i individuelle komponenter, dvs. ord og fraser, ved hjælp af NLP. Derefter kører det disse mod en database, der kaldes et leksikon eller et sentimentbibliotek, som er samlet ud fra en samling ord og fraser, der er blevet indsamlet og tildelt en score manuelt.
Generelt tildeles neutrale ord og fraser en score på nul. Ord, der er markant negative, får en negativ score, og positive ord får en positiv score. I en produktanmeldelse vil ord og fraser som dårlig, skuffende, forfærdelig og rædselsfuld kundeservice for eksempel få en negativ score, mens god, fantastisk, hjælpsom og nyttig vil få en positiv score.
Det er en omfattende proces at opbygge et sentimentbibliotek og de tilhørende regler. Man skal være omhyggelig med at tildele hvert ord en score og også foretage passende sammenligninger. Systemet skal for eksempel forstå, at “dårlig” er et negativt ord, men at “rædselsfuld” er endnu mere negativt; “god” er positivt, og “fantastisk” er endnu mere positivt.
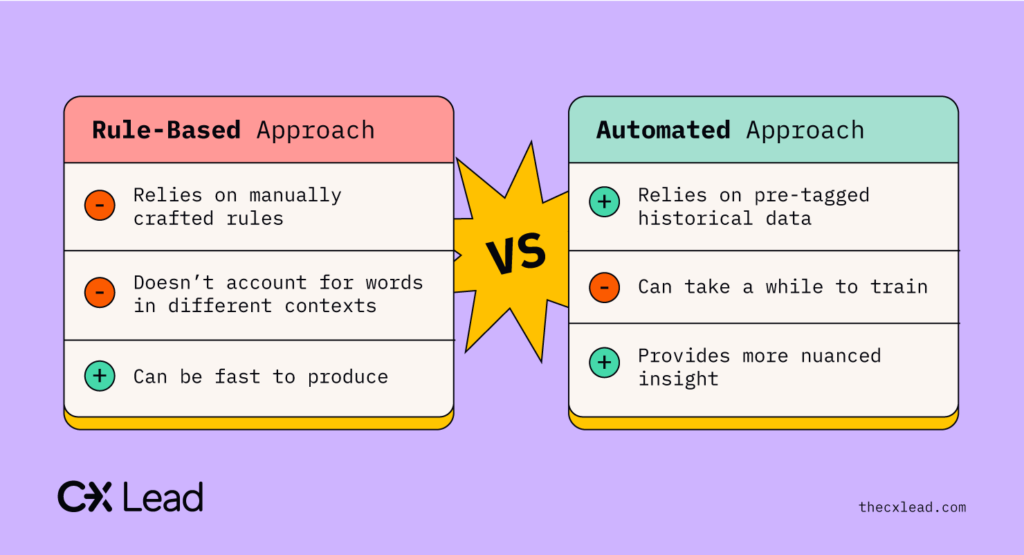
Det regelbaserede system kan være hurtigt at oprette, men er noget begrænset. Det skyldes, at det ikke kan genkende ord, der ikke findes i biblioteket, eller analysere ord i deres kontekst – hvilket gør det vanskeligt at identificere kompleksiteter som sarkasme, homonymer og polysemi. Udtrykket “kald det bare fremragende kundeservice?” kunne for eksempel let blive fejlfortolket.
Regelbaserede systemer kræver også en stor indsats at vedligeholde og opdatere. Man skal hele tiden tilføje nye regler manuelt for at følge sprogets udvikling online. Tilføjelse af nye regler indebærer også en risiko for at påvirke tidligere resultater.
Automatisk sentimentanalyse
I stedet for at være afhængige af et sæt manuelt oprettede og opdaterede regler trænes automatiske sentimentanalysesystemer ved hjælp af maskinlæringsteknikker. I dette tilfælde henviser maskinlæring til algoritmer, der bruger dyb læring til at blive mere præcise, hver gang de støder på en hindring, kræver menneskelig indgriben eller modtager brugerfeedback.
Det bliver teknisk, men her er en forenklet version af, hvordan det fungerer.
- Find et stort datasæt, der ligner de data, du gerne vil analysere, og mærk nogle eksempler. Dette bliver træningsdataene. Du giver ikke systemet regler, du giver det eksempler.
- Brug træningsdataene til at udvikle din maskinlæringsmodel. Den vil bestå af klassifikationsalgoritmer som lineær regression; naive bayes; supportvektormaskiner; RNN-afledningerne LSTM og GRU. Som navnet antyder, bruges disse til at klassificere data (positive, negative, glade, triste osv.). Hvis du er interesseret, kan du finde flere oplysninger om dem her.
- Hvis din model fungerer, vil den, efter at have fået tilstrækkeligt med relevante data, kunne lave sine egne forudsigelser for at klassificere data, den ikke tidligere har set. Den har identificeret sine egne regler!
- Bliv ved med at forbedre disse modellers nøjagtighed ved at give dem flere eksempler.
Fordelen ved den automatiske tilgang er muligheden for at tilpasse og skabe modeller, der er trænet til mange forskellige formål og kontekster.
Vi ved for eksempel, at ordet føniks henviser til en mytisk fugl og også til byen Phoenix i Arizona. En maskinlæringsalgoritme kan trænes til at identificere, hvilken definition af Phoenix der menes i en sætning, ud fra konteksten. Den kan derefter bruge denne erfaring til at genkende lignende tilfælde.
På samme måde markerer en model “woke” (i betydningen ‘at vågne’) som et neutralt ord. “Woke” er imidlertid for nylig blevet slang for “sociopolitisk bevidst”, hvilket gør det til et nyopstået homonym. Når algoritmen har modtaget denne feedback én gang, kan den anvende den nye viden på alle fremtidige analyser. Ordet “woke” får nu en positivt hældende score i bestemte kontekster.
Automatiserede metoder anses generelt for at være bedre. Ulempen ved en automatiseret tilgang baseret på maskinlæring er imidlertid, at den er afhængig af historiske data med labels og kan tage et stykke tid at træne. Den kræver også dataforskere med meget specialiserede kompetencer at udvikle!
Hybrid tilgang
Ved at kombinere naturlig sprogbehandling med maskinlæring, hvilket kaldes en hybridtilgang, vurderes det bredt, at nøjagtigheden af sentimentanalyse forbedres. Naturlig sprogbehandling bruges til at forstå ords sentiment og ordklasser. Maskinlæring bruges til at håndtere sprogets konstante udvikling, se ord i deres kontekst og finde ud af komplekse sprogprocesser som homonymer.
Anvendelser af sentimentanalyse
Som nævnt er sentimentanalyse yderst nyttig for organisationer, der ønsker at vide, hvordan folk opfatter dem. Med så meget data, der hele tiden bliver skabt over hele verden, kan sentimentanalyse hjælpe dig med at skabe mening i det hele i realtid.
Her er nogle af de måder, denne teknologi allerede gør en forskel på:
Reaktion på kundeoplevelsen
Feedback om kundeoplevelsen kan indsamles organisk på nettet (for eksempel omtaler på sociale medier) eller fra feedback, som du selv aktivt indhenter. Forhåbentlig har du et stort og varieret datasæt at arbejde med. Hvis det er tilfældet, er det her, sentimentanalysesoftware hurtigt kan dække meget og give værdifuld indsigt. Denne indsigt kan derefter bruges i din omdømmehåndtering, informere om produktinnovationer og forbedre kundesupport.
Overvåg konkurrenter
Ved at overvåge dine konkurrenters sentiment kan du få et godt indblik i deres position på markedet og sammenligne den med din egen. Lad os for eksempel sige, at dine Twitter-omtaler er 40 procent positive, 30 procent negative, og resten neutrale. Hvordan ved du, om det er godt eller ej? Hvis din største konkurrent for eksempel ligger omkring 60 procent positive, 30 procent negative, og resten neutrale, har du noget arbejde foran dig. Hvis sentimentet derimod er 50 procent negativt, ved du, at du klarer dig fint i forhold til branchestandarderne.
Medarbejderoplevelse
Endelig kan sentimentanalyse hjælpe med at analysere data, som HR-teams bruger til at forstå, hvad der gør medarbejdere tilfredse, eller hvorfor de forlader en virksomhed. Ved at identificere almindelige klager og problemer får arbejdsgivere handlingsorienteret indsigt i, hvordan de kan reducere medarbejderudskiftningen og forbedre medarbejdernes præstationer. Denne funktion er især nyttig for virksomheder med mange medarbejdere, da ledelsen ikke ville have tid til at tale med hundredvis af medarbejdere individuelt.
More Articles
Er sentimentanalyse nøjagtig?
Da en stor del af den sentimentanalyse, vi mennesker foretager, er subjektiv, er det urealistisk at forvente, at et sentimentanalyseværktøj er nøjagtigt 100 procent af tiden. Dataforskere bliver bedre til at udvikle mere nøjagtige sentimentklassifikatorer, men der er stadig et stykke vej.
Hvad er de største udfordringer for en sentimentanalysemodel? Vi har allerede nævnt nogle få, og det er de problemer, der gør sentimentanalyse vanskelig for mennesker. De mest almindelige problemer omfatter:
- Sarkasme. Hvis du nogensinde har brugt tid i kommentarsektionen eller modtaget en sms og ikke var sikker på, om afsenderen mente det alvorligt, ved du, at sarkasme er svært at vurdere i tekst. Overvej følgende to situationer:
Toget er kun 30 minutter forsinket igen i dag. Hvor er det dejligt, at det er pålideligt!
Toget er kun 2 minutter forsinket igen i dag. Hvor er det dejligt, at det er pålideligt!
Det er naturligvis ikke pålideligt, når toget er 30 minutter forsinket, men sentimentanalysesoftware kan have svært ved at opfange det.
- Multipolaritet. Nogle gange kan én sætning være positiv over for én ting og negativ over for en anden. For eksempel: “Pepsi er meget bedre end Coke.” Denne sætning formår at sige noget positivt om Pepsi og negativt om Coke med kun seks ord. Det er usandsynligt, at et sentimentanalysesystem kan bedømme dette system nøjagtigt uden mere avanceret programmering.
- Negationer. En negation opstår, når du vender betydningen af et ord eller en sætning om, for eksempel: “Jeg ville ikke sige, at maden var god.” Vi mennesker kan have svært ved at finde betydningen af en sætning eller et udtryk med en negation, så det er ikke overraskende, at sentimentanalyseværktøjer også kan have problemer.
Konklusion
Nu ved du alt om sentimentanalyse, og hvordan den kan bruges til at analysere data for at vurdere kundernes opfattelse af dit brand.
Sentimentanalyseværktøjer vil klare en stor del af det tunge arbejde for dig, men det er altid klogt at få et menneske til at gennemgå nogle tilfældigt udvalgte eksempler på arbejdet for at kontrollere, om der er ting, som maskiner har svært ved at forstå. Sentimentanalyse er mest effektiv, når teknologi og mennesker arbejder hånd i hånd.
Leder du efter mere indsigt i kundeoplevelsen? Abonner på The CX Lead-nyhedsbrevet.
Relateret læsning: De 10 bedste kundesupportsoftwareløsninger til SMV'er og større virksomheder


