

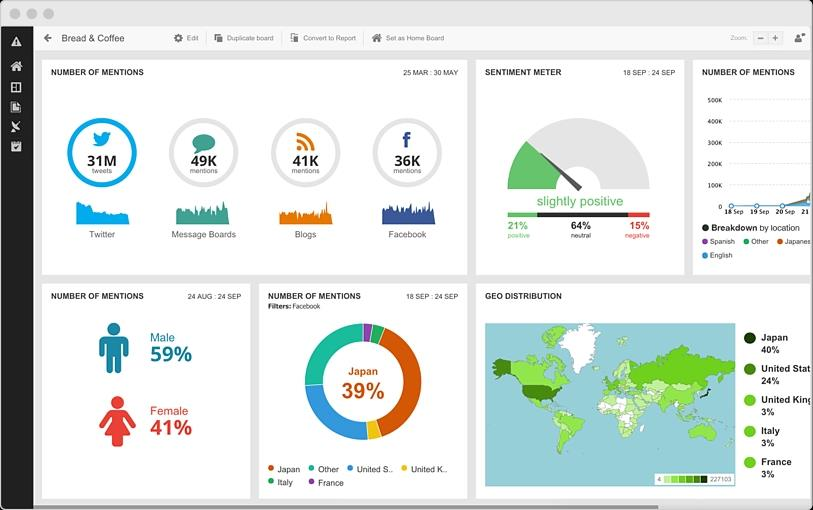
Być może już wiesz, że analiza sentymentu służy do określania, czy dane mają neutralny, pozytywny czy negatywny wydźwięk. Skoro jednak tutaj jesteś, prawdopodobnie nie masz na ten temat dużo głębszej wiedzy.
W tym artykule odpowiem na pytania: Czym jest analiza sentymentu? Jak działa analiza sentymentu? I co analiza sentymentu może dla Ciebie zrobić?
Gdy już zdobędziesz pełną wiedzę na ten temat, możesz zapoznać się z naszą listą 10 najlepszych narzędzi do analizy sentymentu.
Czym jest analiza sentymentu?
Zanim przejdziemy dalej, krótkie przypomnienie, czym jest analiza sentymentu.
Jako ludzie codziennie korzystamy z analizy sentymentu, aby oceniać opinie innych osób. Czasami może to być trudne, na przykład w kontaktach ze szczególnie sarkastycznym przyjacielem lub podczas próby zrozumienia, co tak naprawdę czuje nasz szef, przekazując informacje zwrotne na temat ważnej prezentacji! Oprogramowanie do analizy sentymentu próbuje naśladować to bardzo ludzkie doświadczenie.
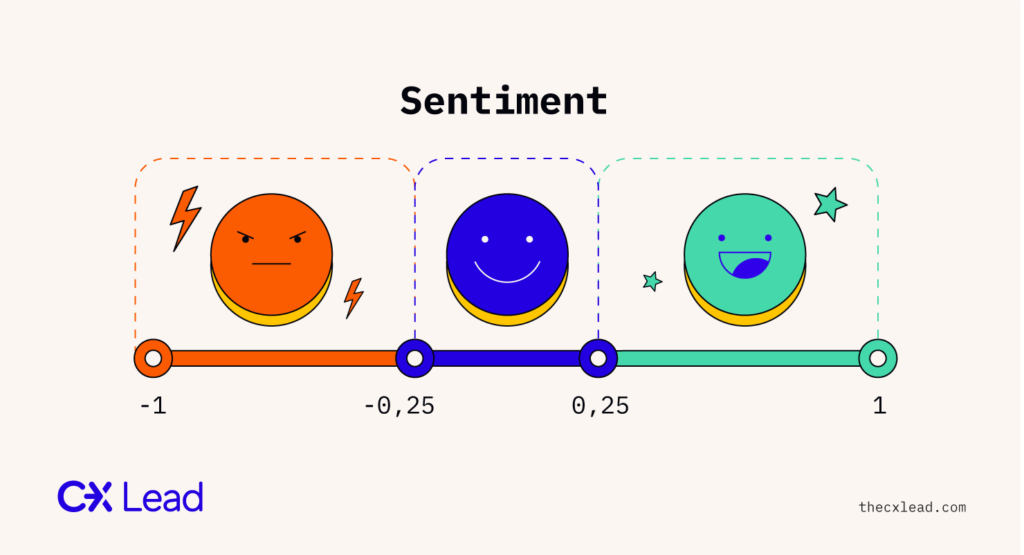
Chociaż niektóre programy potrafią analizować mowę, większość narzędzi do analizy sentymentu służy do analizy tekstu, aby sklasyfikować ogólny wydźwięk tekstu jako pozytywny, negatywny lub neutralny. Nazywa się to biegunowością.
Typowymi źródłami danych do analizy sentymentu są posty w mediach społecznościowych, artykuły prasowe, recenzje internetowe, formularze opinii, odpowiedzi na ankiety oraz strony internetowe, blogi i fora. Analiza sentymentu może być również określana jako eksploracja opinii, sztuczna inteligencja emocjonalna lub, bardziej technicznie, klasyfikacja sentymentu.
Istnieją cztery główne rodzaje analizy sentymentu:
- Szczegółowa, czyli biegunowość (pozytywna, negatywna lub neutralna)
- Uczucia i emocje (szczęśliwy, zły, smutny, rozbawiony)
- Oparta na aspektach (identyfikuje opinię na temat konkretnego aspektu czegoś, np. aparatu w smartfonie)
- Intencja (zainteresowany, niezainteresowany, bardzo zainteresowany).
Narzędzia do analizy sentymentu pomagają przeszukiwać ogromną ilość subiektywnych danych dostępnych w sieci Web 2.0, aby lepiej rozumieć opinie interesariuszy.
Organizacje wykorzystują sentyment na wiele sposobów. Wiele marek stosuje go jako element badań rynku, aby lepiej zrozumieć, które elementy ich strategii marki działają dobrze, a które wymagają poprawy. Innym zastosowaniem jest analiza cyklu informacyjnego przez instytucje finansowe w celu identyfikowania możliwości inwestycyjnych.
Jak działa analiza sentymentu?
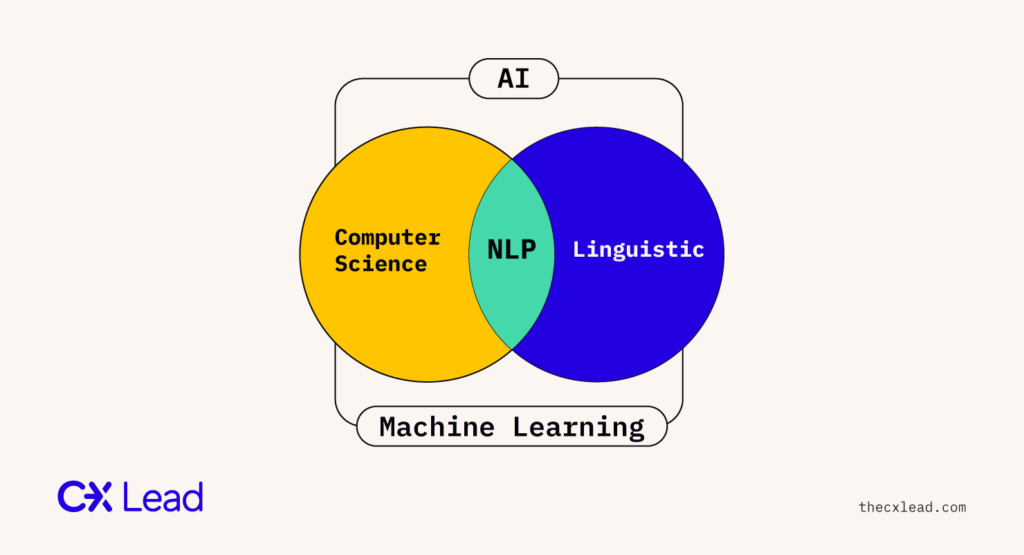
OK, przejdźmy teraz do mechanizmów faktycznego działania analizy sentymentu. W swojej istocie analiza sentymentu jest formą nauki o danych. Dokładniej mówiąc, jest formą przetwarzania języka naturalnego (NLP), będącego poddziedziną sztucznej inteligencji (AI), służącą do identyfikowania i klasyfikowania subiektywnych opinii na podstawie danych tekstowych lub głosowych.
Sztuczna inteligencja w analizie sentymentu klientów znajduje się dokładnie na styku technologii komputerowej i ludzkiej mowy, co jest fascynującą perspektywą dla każdego analityka danych z zamiłowaniem do lingwistyki.
Nie jest to jednak łatwe. Aby prawidłowo zrozumieć język użyty w tekście oraz wygenerować dokładny wynik sentymentu lub wartościowy wgląd, programy muszą stosować różne metody symulujące to, co my, ludzie, robimy intuicyjnie. Symulacje te przyjmują postać zaawansowanych algorytmów (instrukcji dla komputerów).
W tym miejscu pojawiają się dwa główne podejścia do analizy sentymentu:
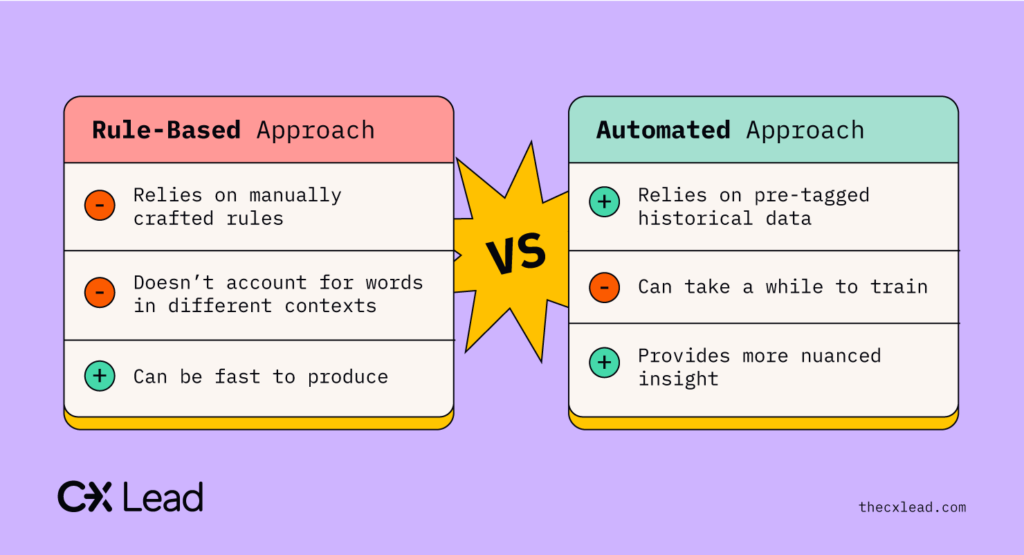
- Oparte na regułach: system wykorzystujący reguły ustalone ręcznie przez ludzi.
- Automatyczne: systemy, które uczą się samodzielnie za pomocą zaawansowanych technik uczenia maszynowego.
Podstawowa różnica między nimi dotyczy sposobu uczenia systemu. Teraz omówimy te podejścia nieco bardziej szczegółowo.
Have an account? Log In
Analiza sentymentu oparta na regułach
Metoda oparta na regułach wykorzystuje NLP wraz z zestawem ręcznie zdefiniowanych reguł, które pomagają identyfikować subiektywność, biegunowość lub przedmiot opinii. Stosowane techniki NLP obejmują między innymi stemming, tokenizację, oznaczanie części mowy, analizę składniową i analizę leksykalną. Jeśli Cię to interesuje, możesz przeczytać więcej na ten temat tutaj.
Oto podstawowy przykład analizy sentymentu opartej na regułach.
Aby określić wydźwięk fragmentu tekstu, narzędzia do analizy sentymentu muszą najpierw podzielić go za pomocą NLP na poszczególne elementy, czyli słowa i wyrażenia. Następnie porównują je z bazą danych, nazywaną leksykonem lub biblioteką sentymentu, utworzoną na podstawie zbioru słów i wyrażeń zebranych ręcznie i ocenionych.
Zazwyczaj neutralnym słowom i wyrażeniom przypisuje się wynik równy zero. Słowa o wyraźnie negatywnym znaczeniu otrzymują wynik ujemny, a słowa pozytywne — wynik dodatni. Na przykład w recenzji produktu słowa i wyrażenia takie jak złe, rozczarowujące, okropne i straszne obsługa klienta otrzymałyby wynik negatywny, natomiast dobre, świetne, pomocne i użyteczne — wynik pozytywny.
Tworzenie biblioteki sentymentu i odpowiadających jej reguł to rozległy proces. Należy uważać, aby przypisać każdemu słowu odpowiedni wynik, a także dokonywać trafnych porównań. Na przykład system musi rozumieć, że „bad” jest słowem o negatywnym znaczeniu, ale „horrible” ma znaczenie jeszcze bardziej negatywne; „good” jest pozytywne, a „amazing” — jeszcze bardziej pozytywne.
System oparty na regułach można szybko utworzyć, ale jest on dość ograniczony. Wynika to z faktu, że nie rozpoznaje słów, które nie występują w bibliotece, ani nie analizuje słów w kontekście — co utrudnia identyfikowanie złożonych zjawisk, takich jak sarkazm, homonimia i polisemia. Na przykład wyrażenie „nazwać to doskonałą obsługą klienta?” można łatwo błędnie zinterpretować.
Systemy oparte na regułach wymagają również dużego nakładu pracy przy utrzymaniu i aktualizowaniu. Aby nadążać za ewolucją języka w internecie, trzeba stale ręcznie dodawać nowe reguły. Dodawanie nowych reguł niesie też ryzyko wpłynięcia na wcześniejsze wyniki.
Automatyczna analiza sentymentu
Zamiast polegać na zestawie reguł utworzonych i aktualizowanych ręcznie, automatyczne systemy analizy sentymentu są trenowane z wykorzystaniem technik uczenia maszynowego. W tym przypadku uczenie maszynowe oznacza algorytmy, które wykorzystują uczenie głębokie, aby stawać się coraz dokładniejsze za każdym razem, gdy napotkają przeszkodę, wymagają interwencji człowieka lub otrzymają opinię użytkownika.
To temat techniczny, ale oto uproszczona wersja wyjaśnienia, jak to działa.
- Znajdź duży zbiór danych podobny do danych, które chcesz analizować, i oznacz przykłady. Stają się one danymi treningowymi. Nie przekazujesz systemowi reguł, lecz przykłady.
- Wykorzystaj dane treningowe do opracowania modelu uczenia maszynowego. Będzie on składał się z algorytmów klasyfikacji, takich jak regresja liniowa, naiwny Bayes, maszyny wektorów nośnych oraz pochodne RNN: LSTM i GRU. Jak sugeruje nazwa, służą one do klasyfikowania danych (pozytywne, negatywne, szczęśliwe, smutne itd.). Jeśli Cię to interesuje, tutaj znajdziesz więcej informacji na ich temat.
- Jeśli model działa poprawnie, po otrzymaniu wystarczającej ilości odpowiednich danych będzie w stanie samodzielnie przewidywać i klasyfikować wcześniej niewidziane dane. Zidentyfikował własne reguły!
- Stale zwiększaj dokładność tych modeli, dostarczając im więcej przykładów.
Zaletą podejścia automatycznego jest możliwość dostosowywania modeli i tworzenia ich do wielu różnych celów oraz kontekstów.
Na przykład wiemy, że słowo feniks odnosi się do mitycznego ptaka, a także do miasta Phoenix w Arizonie. Algorytm uczenia maszynowego można wytrenować tak, aby na podstawie kontekstu rozpoznawał, która definicja słowa Phoenix jest zamierzona, gdy pojawia się ono w zdaniu. Następnie może wykorzystać to doświadczenie do rozpoznawania podobnych przypadków.
Podobnie model oznacza słowo „woke” (w znaczeniu „obudzić się”) jako neutralne. Jednak „woke” stało się ostatnio slangowym określeniem oznaczającym „świadomy społeczno-politycznie”, stając się nowo powstałym homonimem. Gdy algorytm raz otrzyma taką informację zwrotną, może zastosować tę nową wiedzę do każdej kolejnej analizy. Słowo „woke” otrzymuje teraz wynik przechylony w stronę pozytywną w określonych kontekstach.
Metody automatyczne są ogólnie uznawane za lepsze. Wadą podejścia automatycznego opartego na uczeniu maszynowym jest jednak to, że wymaga ono oznaczonych danych historycznych, a jego trenowanie może zająć trochę czasu. Do ich opracowania potrzebni są również wysoko wykwalifikowani analitycy danych!
Podejście hybrydowe
Połączenie przetwarzania języka naturalnego z uczeniem maszynowym, określane jako podejście hybrydowe, jest powszechnie uznawane za sposób na zwiększenie dokładności analizy sentymentu. Przetwarzanie języka naturalnego służy do rozumienia wydźwięku słów i części mowy. Uczenie maszynowe pomaga radzić sobie z ciągłą ewolucją języka, interpretować słowa w kontekście oraz rozpoznawać złożone procesy językowe, takie jak homonimy.
Zastosowania analizy sentymentu
Jak wspomniano, analiza sentymentu jest niezwykle przydatna dla organizacji, które chcą wiedzieć, co ludzie o nich sądzą. Ponieważ na całym świecie cały czas powstaje ogromna ilość danych, analiza sentymentu może pomóc w zrozumieniu ich wszystkich w czasie rzeczywistym.
Oto niektóre sposoby, w jakie ta technologia już przynosi realne korzyści:
Reagowanie na doświadczenia klientów
Opinie dotyczące doświadczeń klientów można pozyskiwać organicznie w internecie (na przykład ze wzmianek w mediach społecznościowych) lub z opinii, o które aktywnie prosisz. Miejmy nadzieję, że masz do dyspozycji duży i zróżnicowany zbiór danych. Jeśli tak, oprogramowanie do analizy sentymentu może szybko objąć analizą dużą część materiału i dostarczyć cennych informacji. Można je następnie wykorzystać w działaniach związanych z zarządzaniem reputacją, przy opracowywaniu innowacji produktowych oraz doskonaleniu obsługi klienta.
Monitorowanie konkurencji
Monitorując sentyment wobec konkurencji, możesz dobrze zrozumieć jej pozycję na rynku i porównać ją z własną. Załóżmy na przykład, że 40 procent wzmianek o Twojej firmie na Twitterze ma pozytywny wydźwięk, 30 procent negatywny, a reszta jest neutralna. Skąd wiesz, czy to dobry wynik? Jeśli Twój największy konkurent ma około 60 procent wzmianek pozytywnych, 30 procent negatywnych, a reszta jest neutralna, masz jeszcze nad czym pracować. Jeśli natomiast 50 procent opinii ma negatywny wydźwięk, oznacza to, że radzisz sobie całkiem dobrze w porównaniu ze standardami branżowymi.
Doświadczenia pracowników
Na koniec analiza sentymentu może pomóc w analizowaniu danych wykorzystywanych przez zespoły HR do zrozumienia, co sprawia, że pracownicy są zadowoleni, lub dlaczego odchodzą z firmy. Identyfikując typowe skargi i problemy, pracodawcy uzyskują praktyczne informacje, które pomagają ograniczyć rotację pracowników i poprawić ich wydajność. Ta funkcja jest szczególnie przydatna w firmach zatrudniających wiele osób, ponieważ kadra zarządzająca nie miałaby czasu na indywidualne rozmowy z setkami pracowników.
More Articles
Czy analiza sentymentu jest dokładna?
Ponieważ znaczna część analizy sentymentu przeprowadzanej przez ludzi ma subiektywny charakter, oczekiwanie, że narzędzie do analizy sentymentu będzie dokładne w 100 procentach przypadków, jest nierealistyczne. Analitycy danych coraz lepiej radzą sobie z opracowywaniem dokładniejszych klasyfikatorów sentymentu, ale wciąż jest jeszcze wiele do zrobienia.
Jakie są największe wyzwania dla modelu analizy sentymentu? Wspomnieliśmy już o kilku z nich — są to problemy, które utrudniają analizę sentymentu również ludziom. Do najczęstszych należą:
- Sarkazm. Jeśli kiedykolwiek spędzałeś czas w sekcji komentarzy albo otrzymałeś wiadomość tekstową i nie miałeś pewności, czy nadawca mówi poważnie, wiesz, że sarkazm trudno rozpoznać w tekście. Rozważ następujące dwie sytuacje:
Pociąg jest dziś znowu spóźniony tylko o 30 minut. Dobrze, że jest taki punktualny!
Pociąg jest dziś znowu spóźniony tylko o 2 minuty. Dobrze, że jest taki punktualny!
Oczywiście pociąg spóźniony o 30 minut nie jest punktualny, ale oprogramowanie do analizy sentymentu może mieć trudności z wychwyceniem tego faktu.
- Wielobiegunowość. Czasami jedno zdanie może wyrażać pozytywny stosunek do jednej rzeczy i negatywny do innej. Na przykład: „Pepsi jest znacznie lepsza niż Coca-Cola”. To zdanie za pomocą zaledwie sześciu słów wyraża coś pozytywnego o Pepsi i negatywnego o Coca-Coli. System analizy sentymentu prawdopodobnie nie będzie w stanie dokładnie ocenić tego zdania bez bardziej zaawansowanego programowania.
- Przeczenia. Przeczenie polega na odwróceniu znaczenia słowa lub wyrażenia, na przykład: „Nie powiedziałbym, że jedzenie było dobre”. Nam, ludziom, czasami trudno jest zrozumieć znaczenie wyrażenia lub zdania zawierającego przeczenie, dlatego nie dziwi fakt, że narzędzia do analizy sentymentu również mogą mieć z tym trudności.
Podsumowanie
Teraz wiesz już wszystko o analizie sentymentu i o tym, jak można ją wykorzystać do analizowania danych w celu określenia opinii klientów o Twojej marce.
Narzędzia do analizy sentymentu wykonają za Ciebie większość ciężkiej pracy, ale zawsze warto poprosić człowieka o przejrzenie losowych próbek wyników, aby sprawdzić, czy nie ma w nich elementów, które trudno zrozumieć maszynom. Analiza sentymentu jest najskuteczniejsza, gdy technologia i ludzie współpracują ze sobą.
Szukasz większej liczby informacji na temat doświadczeń klientów? Zapisz się do newslettera The CX Lead.
Powiązany artykuł: 10 najlepszych programów do obsługi klienta dla małych i średnich firm oraz przedsiębiorstw


