Veel mensen vragen zich af: "Is sentimentanalyse machinaal leren?" Het korte antwoord: ja. Moderne sentimentanalyse maakt gebruik van machinaal leren-modellen om te analyseren en te verbeteren hoe emotionele betekenis in tekst wordt herkend.
In dit artikel leg ik uit wat sentimentanalyse is, wat machinaal leren betekent en hoe de twee samenwerken in de context van de klantervaring.
Wat is sentimentanalyse?
Sentimentanalyse, ook wel opinieanalyse genoemd, is het proces waarbij een verzameling tekst wordt gelezen en wordt geïnterpreteerd of de toon positief of negatief is. Bedrijven gebruiken vaak sentimentanalysetools om te begrijpen hoe klanten over hun merk denken of wat mensen online over hun concurrentie zeggen.
Bij sentimentanalyse krijgen tekstblokken—zoals een tweet of klantbeoordeling—een negatieve, neutrale of positieve score toegewezen op basis van de afzonderlijke woorden waaruit de tekst bestaat.
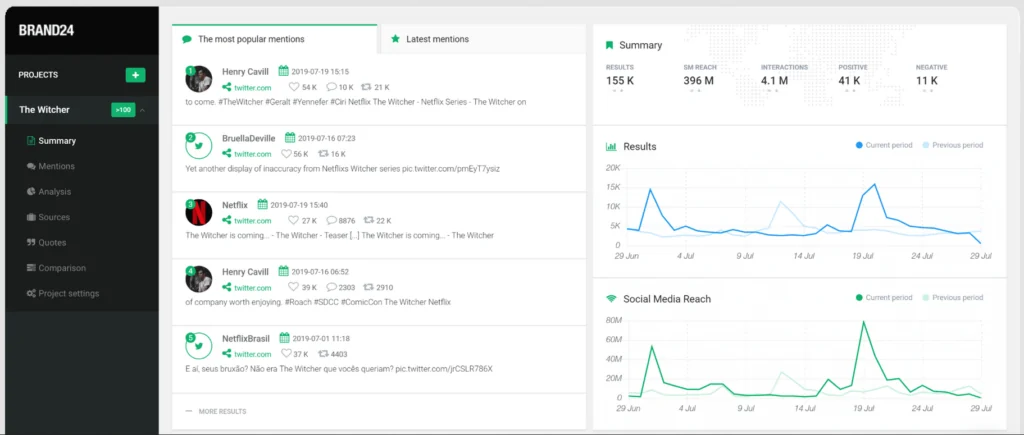
Hiervoor gebruikt sentimentanalysesoftware een lexicon of woordenboek om elk woord te identificeren en te scoren. Dit woordenboek wordt samengesteld door mensen die de woorden handmatig hebben verzameld en aan elk woord een score hebben toegekend.
Dit proces is tijdrovend en uitgebreid, omdat elk woord niet alleen een eigen score nodig heeft, maar de scores ook met elkaar in verband moeten staan. Zo is best beter dan geweldig, en geweldig is beter dan goed.
Dit lexicon vormt de basis van sentimentanalyse.
Hoe werkt sentimentanalyse?
Er zijn drie manieren om sentimentanalyse van klanten te implementeren. Welke manier je kiest, hangt voornamelijk af van de hoeveelheid gegevens die je moet analyseren en hoe nauwkeurig je wilt zijn.
Op regels gebaseerd
Op regels gebaseerde sentimentanalyse is een methode voor kenmerkselectie die automatisch werkt en gebaseerd is op regels die door mensen zijn opgesteld. De regels bevatten doorgaans veel technieken voor natuurlijke taalverwerking (NLP) en naïeve-Bayesclassificaties. Deze aanpak is snel, maar uiterst eenvoudig en niet erg nauwkeurig.
De regels kunnen bijvoorbeeld woorden definiëren die extreem negatief zijn (slechtste, verschrikkelijk, lelijk) en woorden die positief zijn (uitstekend, beste, mooi). Aan deze woorden wordt een positieve of negatieve waarde toegekend. Als er meer positieve woorden dan negatieve woorden zijn, geeft de software aan dat de tekst een positief sentiment heeft; als er meer negatieve woorden zijn, geeft de software een negatief sentiment aan. Als er evenveel positieve als negatieve woorden zijn, wordt de tekst als neutraal beschouwd.
Zoals gezegd is deze aanpak snel, maar niet erg genuanceerd. Er wordt geen rekening gehouden met iets anders dan de eenvoudige regels die op de woorden van toepassing zijn; er wordt geen aandacht besteed aan waar de woorden voorkomen of hoe ze worden gecombineerd. Het is mogelijk om de regels gaandeweg aan te passen, maar daardoor veranderen ook eerdere resultaten. Deze systemen vereisen veel bijstelling en onderhoud.
Have an account? Log In
Automatisch
Automatische systemen worden beschouwd als machinaal leren. Ze zijn voor sentimentclassificatie niet afhankelijk van regels die door programmeurs zijn ingesteld, maar ze moeten wel leren. Tijdens het trainen van automatische systemen leert het systeem bepaalde woorden en tekstcombinaties te koppelen aan een specifiek label. De tekst wordt omgezet in een kenmerkvector. De machine koppelt labels en kenmerkvectoren om een algoritme te genereren en een model te creëren dat voortaan kan worden gebruikt.
Kenmerkvectoren vertegenwoordigen alle kenmerken en eigenschappen van een object; in dit geval de woorden en zinnen. Bij machinaal leren en AI voor sentimentanalyse van klanten zijn ze essentieel voor patronen en algoritmen die de gegevens verwerken. Dus hoe meer tests het systeem krijgt, hoe meer labels en kenmerkvectoren het creëert en hoe meer het zijn algoritme en sentimentanalysemodel leert en verfijnt.
Dit proces kan behoorlijk complex worden en uitmonden in diep leren, waarbij een verzameling algoritmen en kunstmatige neurale netwerken wordt gebruikt om gegevens te analyseren, in een poging het denkproces van het menselijk brein na te bootsen.
Hybride
Een hybride aanpak gebruikt een combinatie van op regels gebaseerde en automatische sentimentanalyse, waarbij idealiter de beste onderdelen van beide worden genomen en samengevoegd tot één geheel. Deze methode is doorgaans het nauwkeurigst.
Hoe sentimentanalyse en machinaal leren met elkaar verbonden zijn
Machinaal leren is een belangrijk onderdeel van sentimentanalyse, maar het is niet het enige dat ertoe doet.
Door natuurlijke taalverwerking te gebruiken, kunnen programmeurs enorme hoeveelheden tekst en gegevens invoeren bij het opbouwen van een sentimentlexicon en het trainen van het programma voor machinaal leren. Het programma blijft meer woorden beoordelen, waardoor het algoritme en het vermogen om sentimentanalyse en uiteindelijk sentimentvoorspellingen uit te voeren worden verbeterd. Deze verbeteringen worden ondersteund door algoritmen voor machinaal leren.
Sentimentanalyse met machinaal leren moet veel zaken uitzoeken om zo nauwkeurig mogelijk te zijn. Daarom heeft een model voor diep leren de voorkeur.
Voor nauwkeurige sentimentanalyse is een grondig begrip van de woordsoorten vereist. Programmeurs trainen machinaal leren hiervoor door elk woord te labelen als zelfstandig naamwoord, werkwoord, bijvoeglijk naamwoord enzovoort.
Naarmate het programma meer leert over zinsstructuur en over de manier waarop woorden in zinnen worden gerangschikt en geplaatst, bouwt het voort op zijn basiskennis van natuurlijke taal, waardoor de nauwkeurigheid van de classificatie verbetert.
Toch zijn er veel obstakels die het machinaal leren voor sentimentanalyse op de proef stellen.
Uitdagingen voor machinaal leren bij sentimentanalyse
Er zijn veel uitdagingen bij sentimentanalyse, ongeacht het model dat je gebruikt.
Sentimentanalyse is iets wat wij als mensen voortdurend doen. Telkens wanneer we een bericht van een vriend of een tweet van een onbekende lezen, moeten we bepalen wat het sentiment werkelijk is. Zijn ze sarcastisch? Grappig? Ironisch?
Het is voor mensen moeilijk om altijd honderd procent nauwkeurig de betekenis achter tekst te bepalen. Als mensen hiermee al moeite hebben in hun moedertaal, is het logisch dat machinaal leren ook wat moeite heeft met sentimentanalyse.
Hier zijn enkele zaken die sentimentanalyse moeilijk maken voor machinaal leren:
Subjectiviteit
Sommige uitspraken zijn feitelijk en niet positief of negatief, maar het is niet altijd eenvoudig om dit onderscheid te maken. Bekijk bijvoorbeeld de volgende twee zinnen:
Het shirt is blauw.
Het shirt is prachtig.
In dit voorbeeld is het duidelijk welke zin een positief sentiment heeft: het shirt is prachtig. Maar dat betekent niet dat de eerste zin negatief is. De eerste zin is objectief. Er wordt een feit vermeld: het shirt is blauw.
De moeilijkheid ontstaat doordat twee predicaten soms niet gelijkwaardig zijn. De tweede zin, waarin wordt gezegd dat het shirt prachtig is, is vanuit het perspectief van sentiment belangrijker omdat deze subjectief is. De tweede opmerking geeft aan hoe een gebruiker over een product denkt, en dat is bruikbare informatie.
Toon
Toon is een van de moeilijkste zaken om voor mensen te ontcijferen, dus stel je voor hoe moeilijk het voor een machine kan zijn. Het is bijvoorbeeld bijzonder moeilijk om aan de hand van tekst te bepalen of iemand sarcastisch is, omdat mensen meestal woorden gebruiken die het tegenovergestelde betekenen van wat ze bedoelen. Bijvoorbeeld:
Mijn geweldige auto is weer kapotgegaan. Geweldig!
Mijn waardeloze auto is weer kapotgegaan.
Deze twee zinnen hebben allebei een negatief sentiment, maar in de eerste zin wordt sarcasme gebruikt door woorden als geweldig en fantastisch op te nemen. Deze situatie zou voor een sentimentanalysesysteem moeilijk te begrijpen zijn zonder dat een mens de tekst bekijkt en een definitieve beoordeling maakt.
Context
In sommige gevallen is het onmogelijk om het sentiment te bepalen zonder een bredere context. Beschouw het volgende sentiment: “Het assortiment in deze winkel voor kunstbenodigdheden is geweldig als je schilderkunst studeert.” Bij het scannen van de tekst zien we positief beoordeelde woorden zoals “geweldig.”
Een bredere context van dit citaat impliceert echter iets anders: dat de winkel voor kunstbenodigdheden niet zo geweldig is als je je richt op potlood, inkt, beeldhouwkunst of een ander type artistiek medium. Oeps. Als je de context in overweging neemt, zou je kunnen besluiten dat deze beoordeling uiteindelijk niet zo positief is!
Wanneer machinaal leren meningen analyseert op sentiment, houdt het niet altijd goed rekening met de context.
Vergelijkingen
Vergelijkingen zijn complex omdat ze niet zozeer over de woorden gaan, maar over de manier waarop de woorden zich tot elkaar verhouden. Hier is een voorbeeld:
Dit is de beste taart die ik ooit heb gegeten.
Hun taart is goed voor een restaurantketen.
De eerste zin is positief. De tweede is minder eenvoudig vast te stellen. Waarschijnlijk wilt u dat uw product goed is in vergelijking met alle soorten concurrentie. Het tweede sentiment impliceert dat uw taart, in vergelijking met gespecialiseerde bakkers, lokale zaken of andere locaties, van een tweede rang is.
Sentimentanalysesystemen pikken de vergelijkingsfactor hier mogelijk niet op. In plaats daarvan zouden ze het woord “goed” lezen en het sentiment positief scoren, ook al is er duidelijk meer aan de hand.
Emoji's
Iedereen die tijd online doorbrengt, weet dat emoji's overal zijn. Sommige zijn eenvoudig, andere ingewikkeld, maar ze kunnen allemaal problemen veroorzaken voor machinaal leren dat sentimentanalyses probeert uit te voeren.
Emoji's zijn een belangrijk onderdeel van online communicatie. Een hart-emoji moet als een positief sentiment worden gelezen, terwijl de emoji van een hoopje poep zeker negatief zou scoren. Dit is geen probleem zolang u werkt met sentimentbibliotheken die scores invoeren voor veelgebruikte emoji's, net zoals ze dat kunnen doen voor populaire straattaal.
More Articles
Straattaal
Taal evolueert voortdurend en dat geldt ook voor het straattaallexicon van elke generatie, zoals “smol”, “stan”, “woke” en “salty”. Net als bij emoji's kan uw sentimentanalysetool hier moeite mee hebben.
Er lijkt immers om de paar maanden een nieuw, door memes geïnspireerd straattaalwoord te ontstaan. Straattaal die blijft bestaan en in beoordelingen en op sociale media kan worden toegevoegd aan de sentiment bibliotheek en een positieve, neutrale of negatieve score kan krijgen... net als elk ander woord!
Ons taalwoordenboek evolueert voortdurend. Ik herinner me de collectieve oogrol toen YOLO (je leeft maar één keer, voor wie niet is ingewijd) in 2014 werd opgenomen in het online woordenboek van Oxford. Sentimentanalysers hebben echter hoop: dit betekent dat ML-woordenboeken ook kunnen evolueren. De beste sentimentanalysetools zullen nieuwe straattaal ondersteunen via software-updates of handmatige invoer door gebruikers.
Middenweg: wat is een neutraal sentiment?
Een manier om een goede basis te leggen voor het trainen van machinaal leren is om enige tijd na te denken over wat “neutraal” precies betekent. Ik heb veel gesproken over positieve en negatieve voorbeelden voor een sentimentanalyser, maar die twee sentimenten zijn afhankelijk van een duidelijk gedefinieerd neutraal sentiment. Het is redelijk om te zeggen dat het neutrale sentiment een van de belangrijkste onderdelen van het proces is.
Maar hoe definieert u neutraal? Hier zijn 3 manieren om te beginnen:
- Neem objectieve tests op. Denk aan het bovenstaande voorbeeld: dit shirt is blauw. De auto is geel. De boom heeft bladeren. Dit zijn allemaal objectieve uitspraken die op feiten zijn gebaseerd. Ze bevatten geen positief of negatief sentiment.
- Filter alles uit wat niet relevant is. Irrelevante informatie helpt u niet bepalen of iets positief of negatief is. Als een beoordeling van een wasdroger bijvoorbeeld begint met een anekdote zoals “Ik ging naar de kelder en gooide de natte kleding in de droger, om vervolgens te ontdekken dat deze kapot was”, is deze informatie niet relevant voor het sentiment van de beoordeling zelf en kan deze worden weggelaten.
- Negeer suggesties. Dit is geen strikte regel, maar vaak dragen suggesties niet bij aan het sentiment. Als u merkt dat beoordelaars wensen dat een artikel een bepaalde functie had, vertelt dit u niet veel over het klantsentiment. In eerste instantie denkt u misschien dat dit negatief is, en dat kan ook zo zijn. “De biefstuk was verschrikkelijk, ik wou dat ze hem niet te gaar hadden gebakken” is bijvoorbeeld negatief. Maar wensen en verlangens kunnen ook in positieve beoordelingen voorkomen. “De taart was heerlijk, ik wou dat er meer was” of “Ik ben dol op alles aan dit shirt, ik wou dat het in 100 kleuren verkrijgbaar was.”
Een duidelijk gedefinieerd neutraal sentiment vormt de basis van elke sentimentanalyse. Elke analyse begint immers neutraal en buigt vervolgens naar positief of negatief naarmate de tekst wordt gescoord.
Conclusie
Sentimentanalyse is een type hulpmiddel voor machinaal leren. Machinaal leren werkt samen met natuurlijke taalverwerking om de belangrijkste bouwstenen van het sentimentanalyseproces te vormen.
Machinaal leren beschrijft echter simpelweg hoe computers leren en hoeft niet altijd verweven te zijn met sentimentanalyse. Er is ook machinaal leren voor chatbots voor klantenservice, bedrijfsprognoses, systemen voor productaanbevelingen, dynamische productprijzen en meer.
Abonneer u op de nieuwsbrief van The CX Lead voor meer deskundige inzichten in klantervaring en gebruikerservaring.